理解智能体中的五种Workflow
上一篇我们从一个最小 Agent 出发,认识了模型、工具、检索和记忆。这次,我们再往前一步,看看当任务变复杂时,程序可以怎样组织模型调用。
当任务需要分几步完成时,程序可能会多次请求模型,并将每次结果传给后续步骤。一次这样的“请求—回答”就是一次模型调用(LLM Call)。
接下来介绍的五种工作流模式,关注的是如何组织这些调用:提示链、路由、并行化、编排者—工作者和评估者—优化者。它们也可以根据任务需要组合使用。
1. 提示链:按步骤依次完成
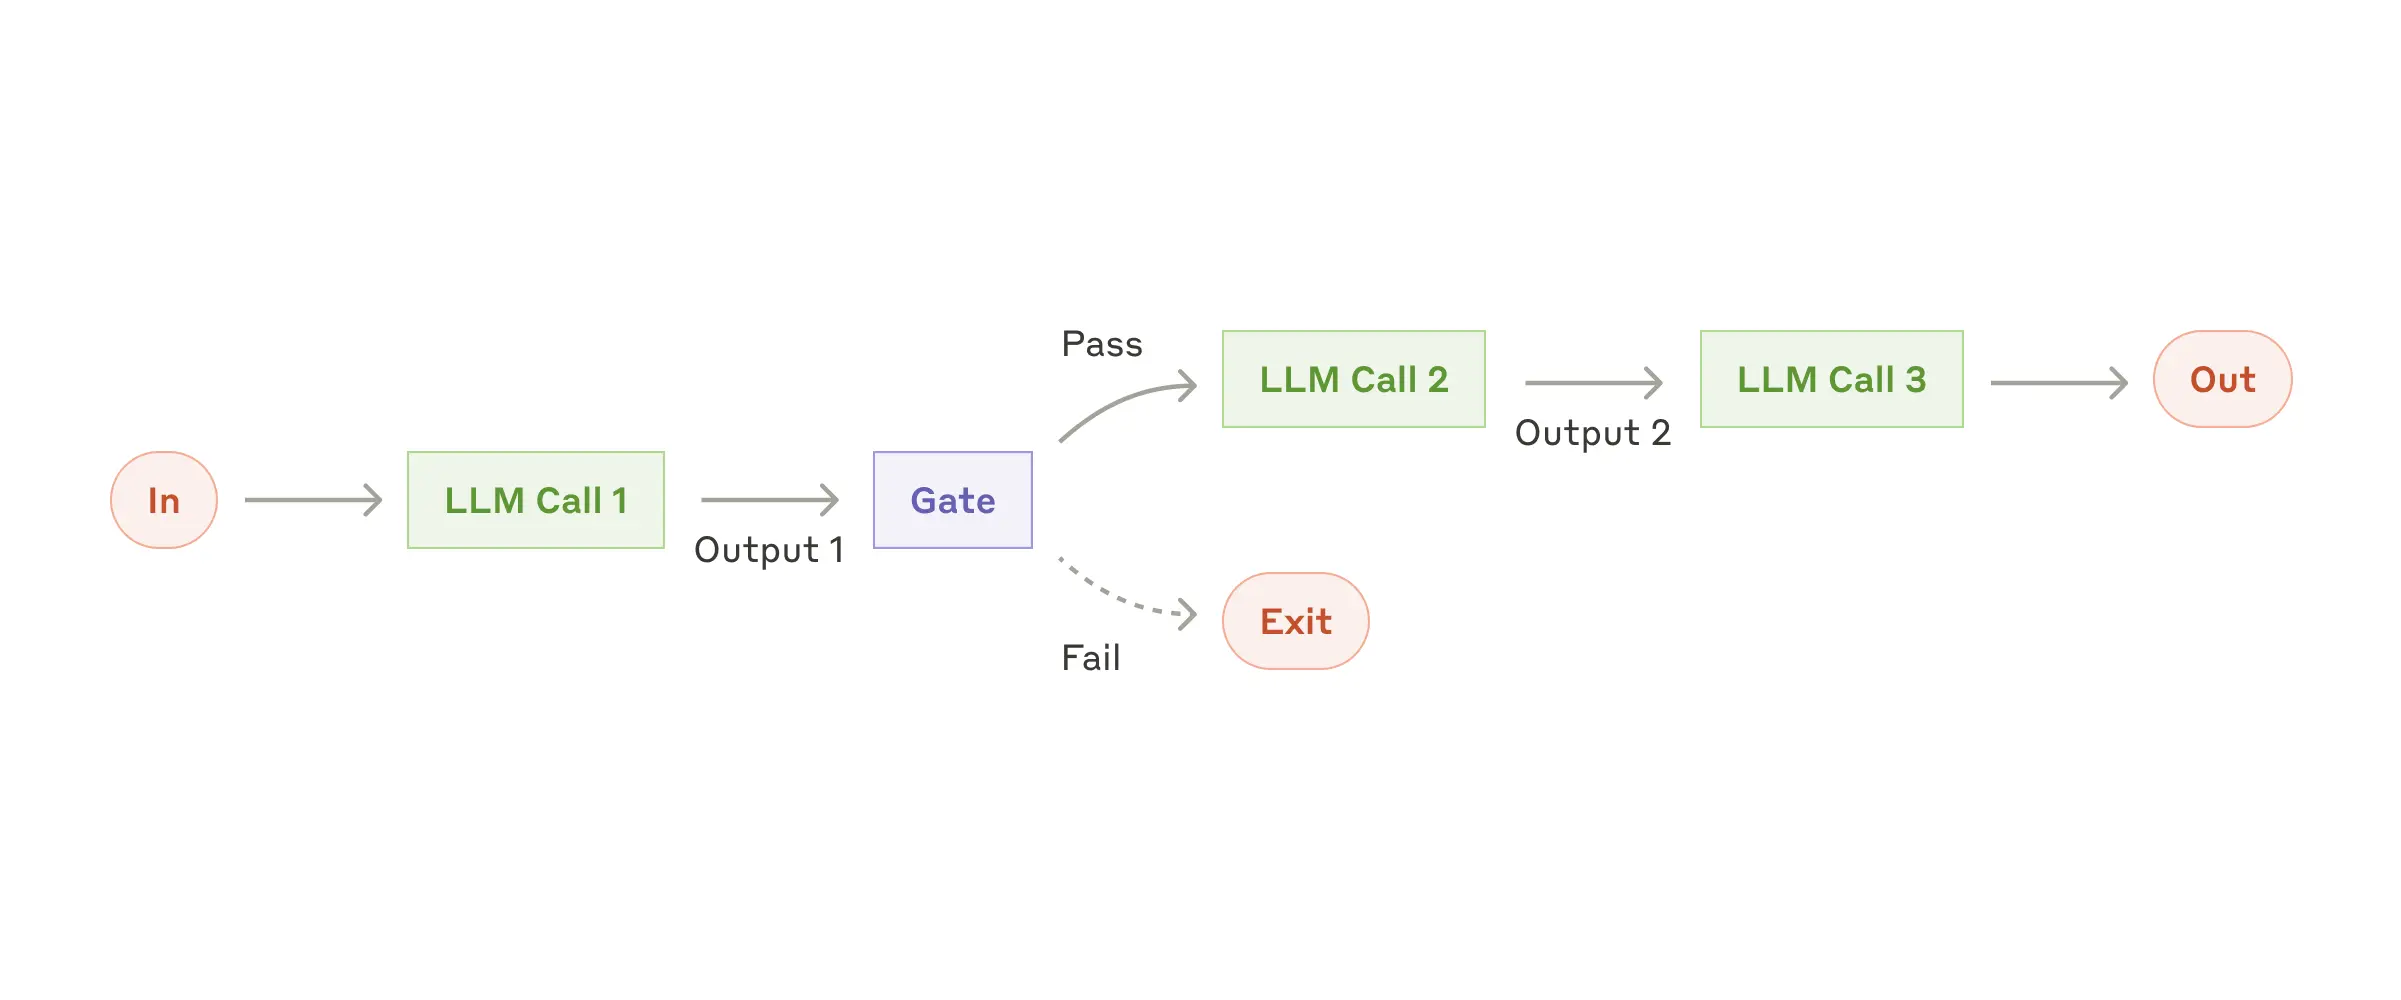
Prompt Chaining(提示链)把一个任务拆成固定顺序的步骤。前一步的输出成为后一步的输入,每次模型调用各自完成一个范围清楚的小任务。
用户输入
   ↓
LLM Call 1:生成文章提纲
   ↓
Gate:检查提纲是否覆盖必需章节
   ↓ 通过
LLM Call 2:根据提纲撰写正文
   ↓
输出文章
其中的 Gate(检查点)通常是程序执行的一条明确规则,例如字段是否齐全、格式是否有效、长度是否超限。检查失败时,程序可以停止、报错或安排重试。Gate 不一定是一次额外的模型调用。
提示链适合步骤和先后顺序都比较确定的任务,例如先生成营销文案再翻译,或先写提纲、检查提纲后再写全文。它让每一步更容易检查和调整,但需要多次调用模型,整体耗时也会增加。
2. 路由:先判断,再分流
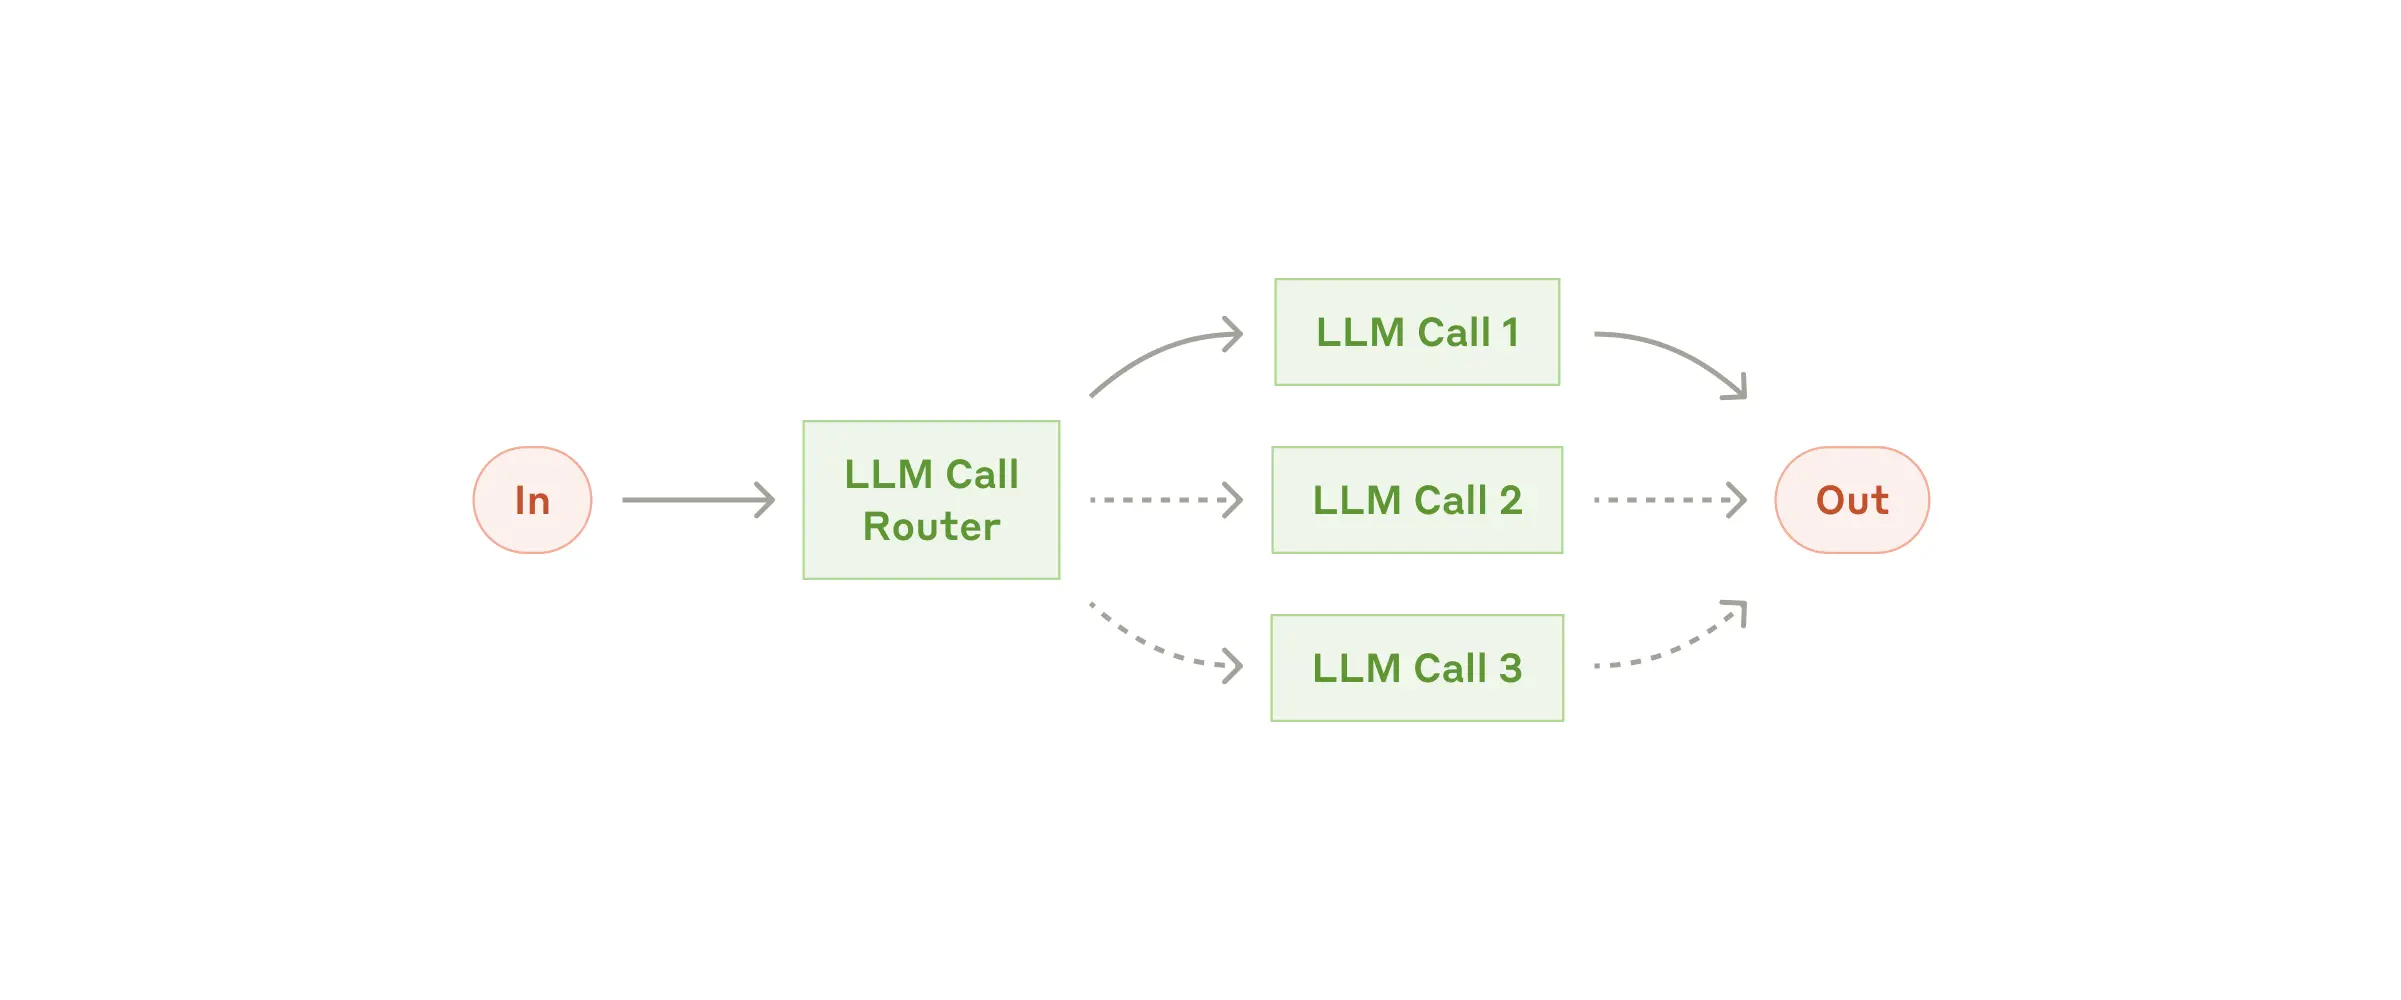
Routing(路由)先对输入分类,再把它送到最适合的后续任务。路由器可以是一次模型调用,也可以是规则或传统分类模型。
用户问题
   ↓
Router:识别问题类型
   ├─ 普通咨询 → LLM Call 1:知识问答
   ├─ 退款请求 → LLM Call 2:退款流程
   └─ 技术问题 → LLM Call 3:技术支持
                     ↓
                  返回结果
路由适合输入类别清楚、不同类别需要不同提示词、模型、工具或业务流程的场景,例如客服问题分流。它能让每个后续流程专注处理自己的任务;同时要考虑分类错误,并准备合适的兜底路径。
3. 并行化:同时处理,再汇总
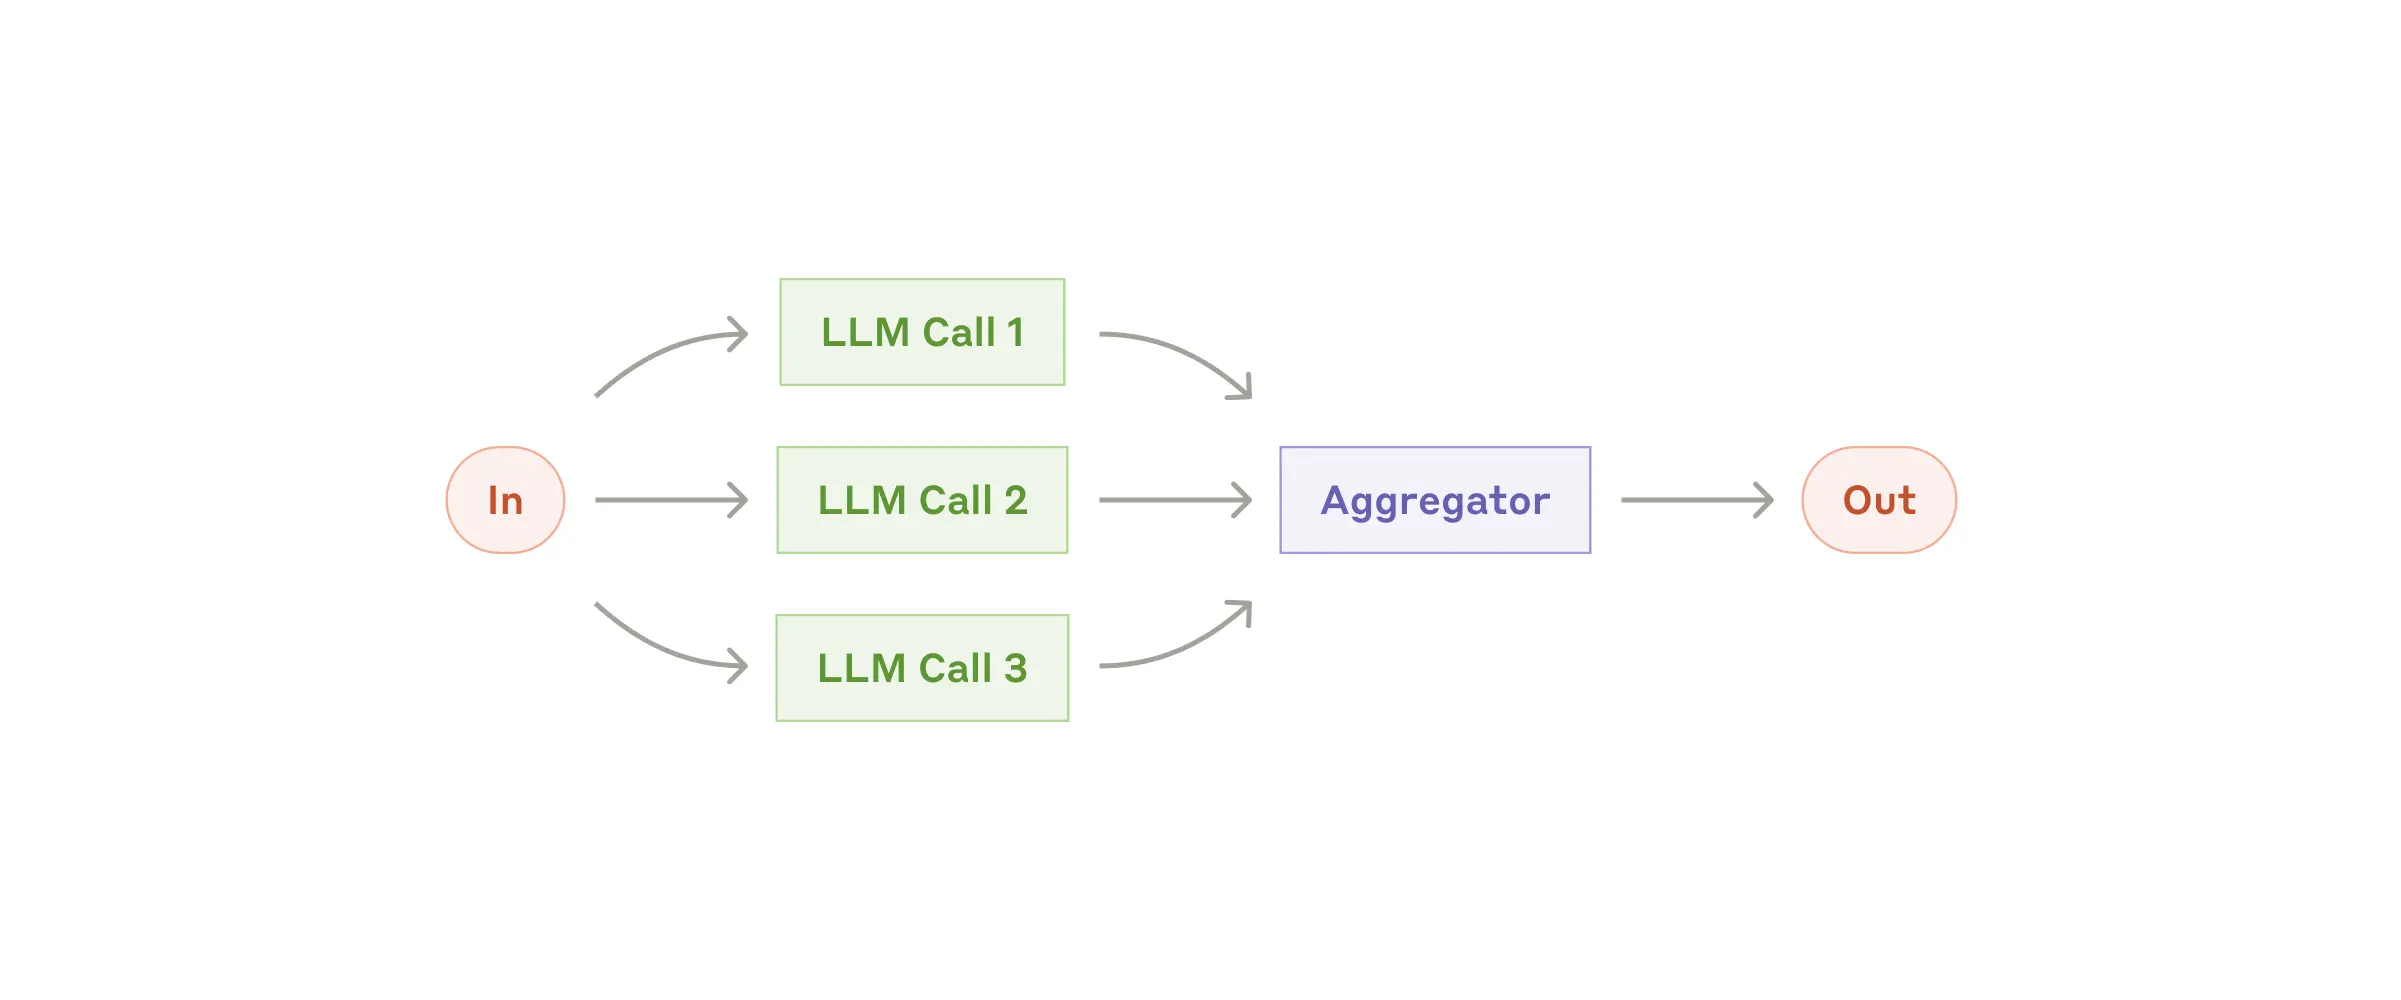
Parallelization(并行化)让多个模型调用同时工作,再由程序汇总结果。它有两种常见变体:分段和投票。
分段:分工做不同的事
程序把任务拆成彼此独立的部分,并行交给不同调用。例如审查代码时,一个调用检查安全问题,一个检查性能,另一个检查可读性,最后把发现合并。
投票:多次做同一件事
程序把同一个问题交给多个调用,让它们独立判断,再按照多数票、评分或阈值等规则综合结果。例如多个调用分别判断一段内容是否为垃圾信息,再由程序统计判断。
同一输入
   ├─ LLM Call 1 ─┐
   ├─ LLM Call 2 ─┼→ Aggregator:合并结果 → 输出
   └─ LLM Call 3 ─┘
程序通常会异步发出这些请求,再等待所需结果完成后汇总;也可以设置超时,或在达到票数后提前结束。并行化适合子任务互不依赖、需要缩短等待时间,或希望通过多次判断提高信心的情况。它会增加模型调用量,汇总规则也需要设计清楚。
4. 编排者—工作者:动态拆解和委派
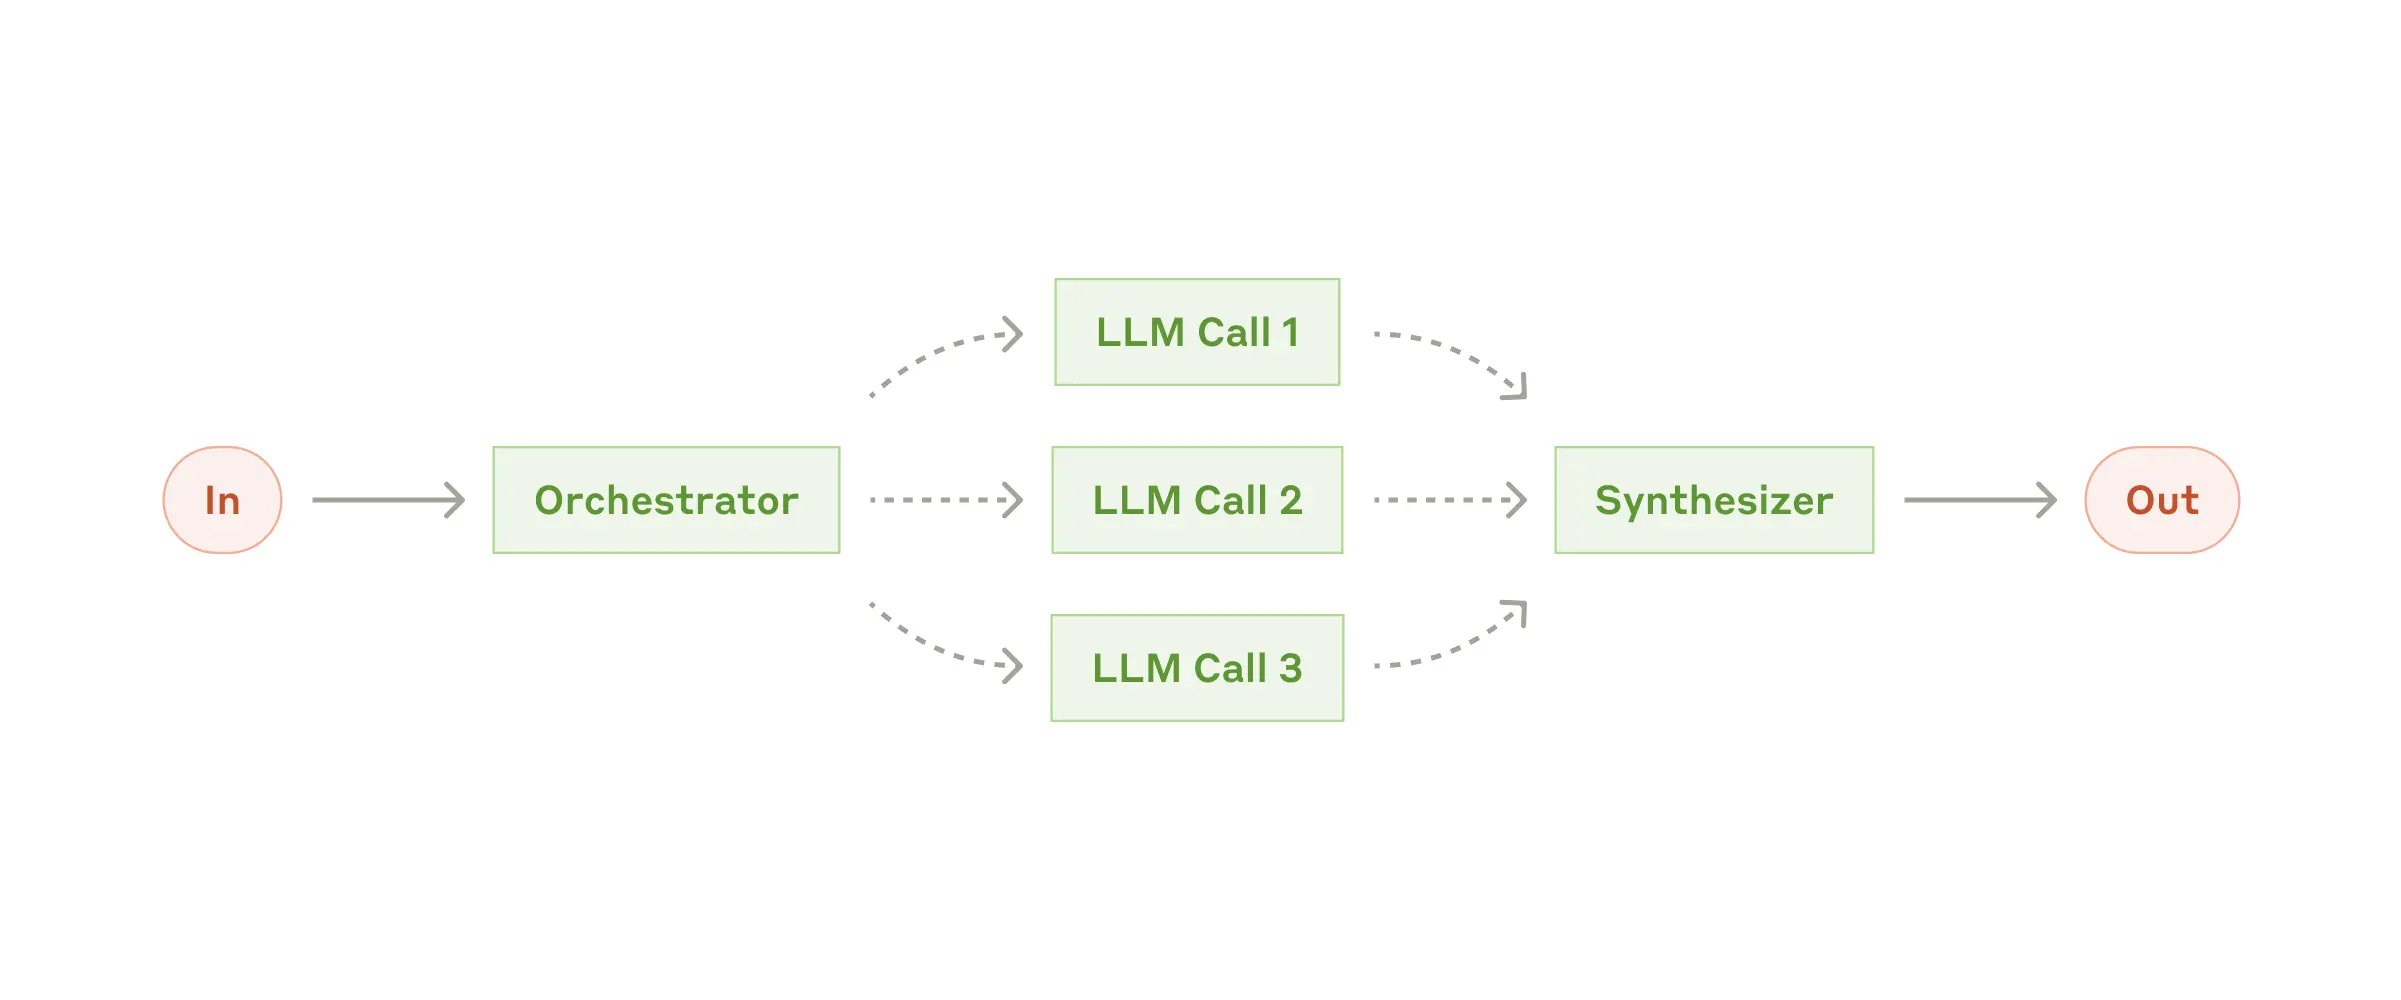
Orchestrator-Workers(编排者—工作者)适合任务复杂、开始时难以预先列出所有子任务的情况。一个中心模型先分析输入,动态拆解任务并分派给工作者,最后综合结果。
用户的复杂任务
   ↓
Orchestrator:分析任务并安排工作
   ├─ Worker 1:完成子任务 A ─┐
   ├─ Worker 2:完成子任务 B ─┼→ Synthesizer:检查并整合 → 输出
   └─ Worker 3:完成子任务 C ─┘
例如,修改一个涉及多个文件的软件项目时,编排者可以先分析改动范围,再安排工作者分别处理接口、页面和测试。若这些子任务互不依赖,就可以并行;若后一步依赖前一步结果,编排者也可以安排顺序执行。
它和固定的并行分段不同:固定分段通常由程序事先规定工作内容;编排者—工作者则会根据具体输入决定需要拆出哪些工作。代价是编排和整合更复杂,也要防止重复、遗漏或互相冲突的结果。
5. 评估者—优化者:根据反馈反复改进
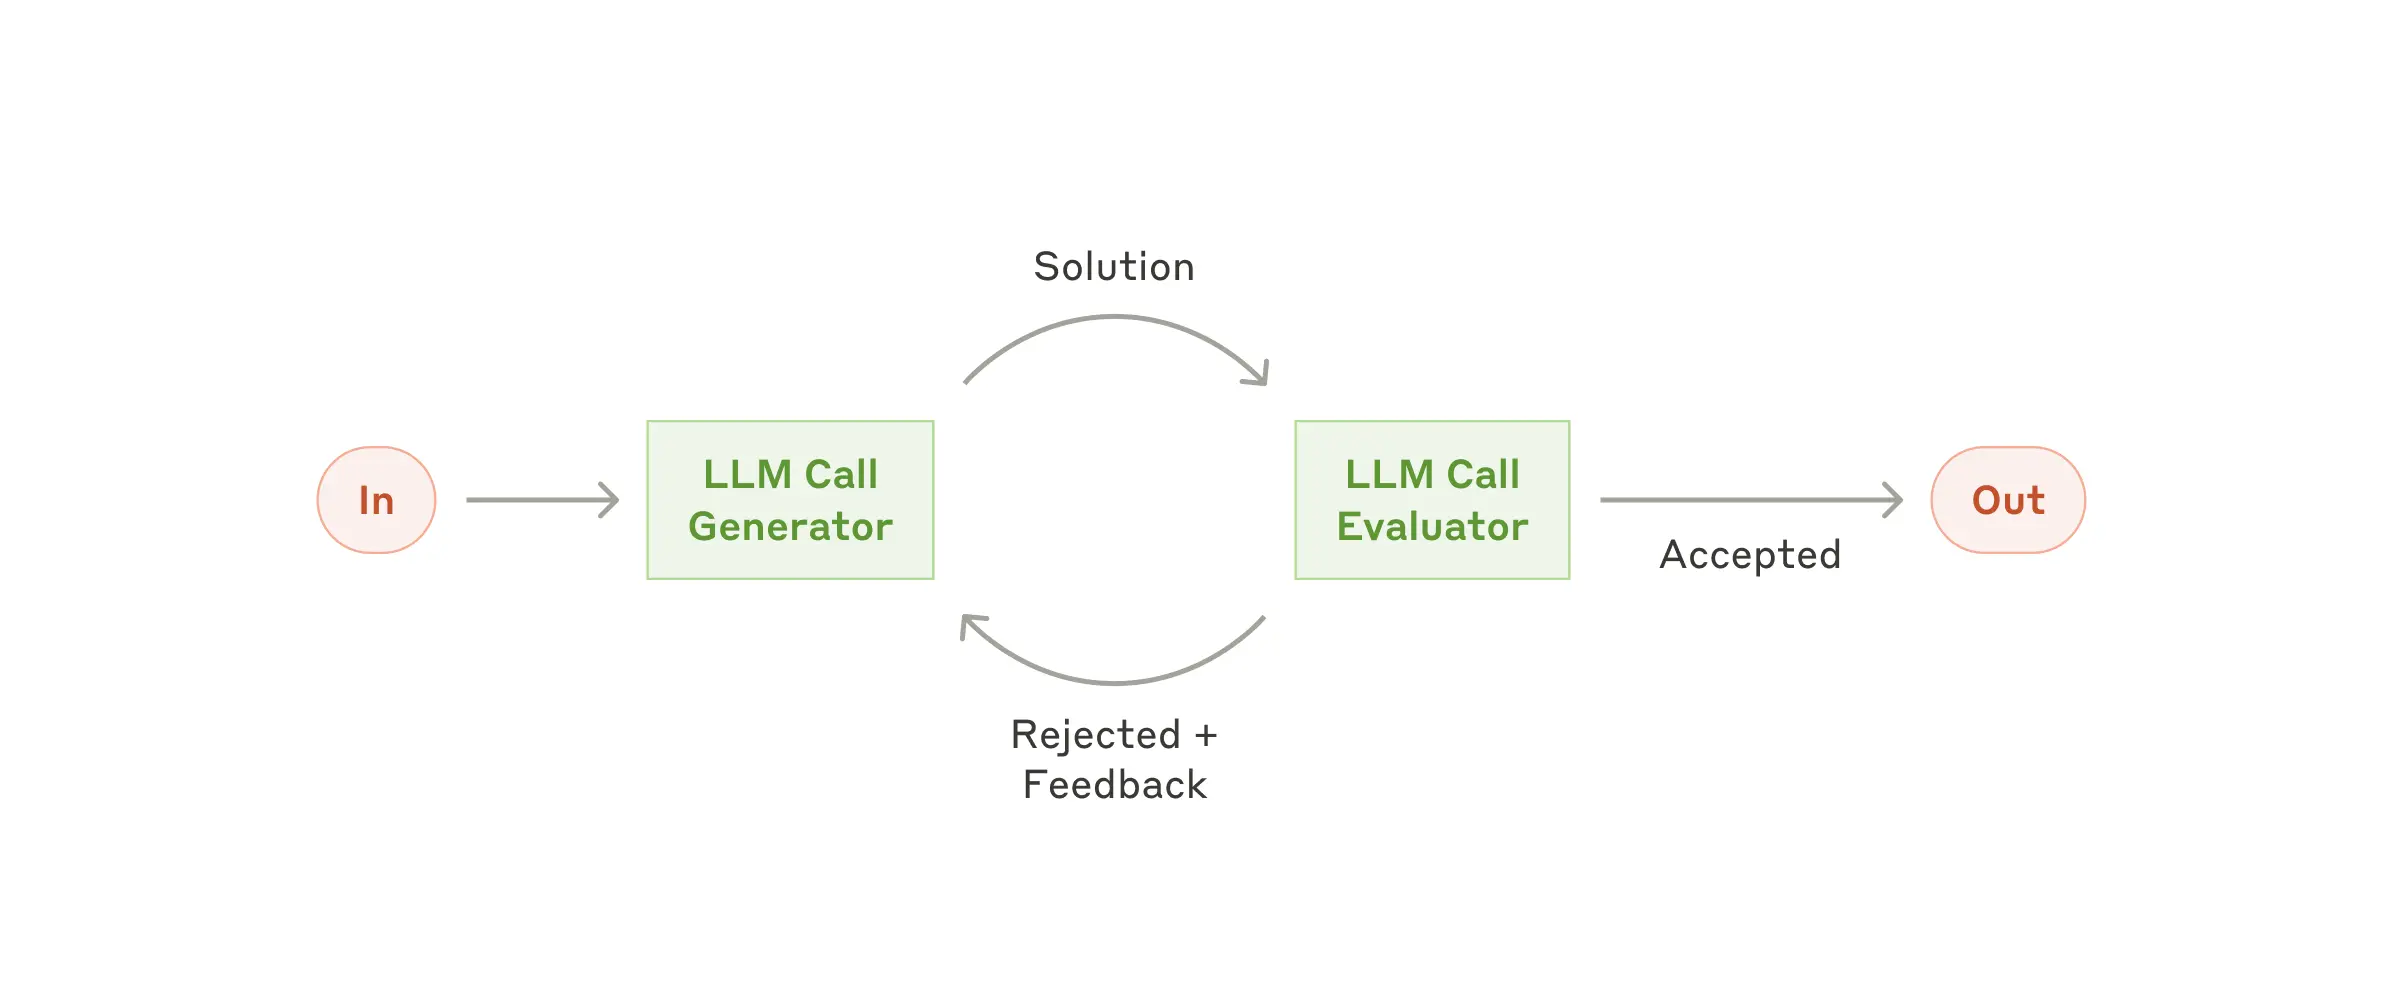
Evaluator-optimizer(评估者—优化者)让一个模型先生成结果,另一个模型或程序按评价标准检查,并将反馈交给生成者修改。这个过程重复进行,直到通过检查或达到停止条件。
输入
   ↓
Generator:生成初稿
   ↓
Evaluator:依据标准检查
   ├─ 通过 → 输出
   └─ 未通过 + 修改意见 → Generator 再生成
例如翻译任务可以检查术语、语气和遗漏,再让生成者按意见修改。它适合评价标准明确、反复修改能带来可衡量提升的任务。应设置最大迭代次数,并让反馈具体可执行;否则模型可能一直循环,或在模糊反馈下反复改写却没有实质改善。
五种模式怎么选?
- 步骤和顺序固定:考虑提示链。
- 输入类别不同,需要走不同流程:考虑路由。
- 子任务独立,或需要多次判断:考虑并行化。
- 子任务要根据输入临时确定:考虑编排者—工作者。
- 有清晰标准,值得迭代打磨:考虑评估者—优化者。
这些模式并不互斥。一个复杂系统可以先用路由识别任务,再由编排者安排工作者并行处理,最后用评估者检查结果。选择时先看任务步骤是否固定、子任务是否独立、是否需要动态拆解,以及结果能否用明确标准评估。
这些模式怎么实现:自己编排还是用框架?
两种方式都可以。框架不会替我们决定业务流程;它主要提供模型接入、状态管理、节点编排、并发执行、重试和持久化等基础设施。即使使用框架,我们仍要定义每一步做什么、步骤之间怎样传递数据,以及什么条件下继续或停止。
如果目标是学习原理,或流程只有几步,自己编排通常最清楚。以 Java 为例,可以把每一步写成方法:提示链按顺序调用方法;路由用分类结果选择分支;并行化用线程池或 CompletableFuture 发出独立任务,并等待结果后汇总;编排者—工作者先让模型生成结构化子任务,再由程序分派给工作者;评估者—优化者则用有上限的循环完成“生成—评价—修改”。
自己实现的好处是调用过程透明、容易调试,也能直接看见工作流和普通 Java 代码的关系。代价是系统变复杂后,需要自己补上超时、重试、并发限制、错误处理、运行记录和状态保存;如果这些细节没有设计好,流程中断后可能无法恢复,模型调用也可能无限重试。
如果项目已经使用 Spring,可以用 Spring AI 的 ChatClient 统一调用模型,并组合工具调用等能力。它帮我们处理一些模型交互环节,但具体工作流仍由应用程序编排。
对于更复杂的 Java Agent 工作流,可以进一步看 Spring AI Alibaba Graph 和它的 Agent Framework。Graph 把步骤组织成节点,让节点通过共享状态和条件边连接;框架也提供顺序、并行、路由和循环等常用结构,并支持更完整的流程编排能力。采用前要核对项目所需的 JDK、Spring 和依赖版本;当前仓库说明要求 JDK 17 或更高版本,而本章的基础 Demo 使用 Java 11。
一个实用的学习路径是:先用普通 Java 把五种模式分别写出来,确认自己理解了调用顺序和数据流;当开始需要持久化状态、失败恢复、人工审核、追踪每个节点等能力时,再引入框架。这样换了框架,也仍然知道它帮我们接管了哪部分工作。
小结
这五种模式关心的都是同一个问题:程序如何安排模型完成工作。提示链强调依次执行,路由强调分类分流,并行化强调同时处理,编排者—工作者强调动态拆解,而评估者—优化者强调反馈循环。理解这些模式后,我们就能根据任务特点设计合适的调用流程,而不是把所有工作都塞进一次模型请求。