AIOT架构
作者: admin
实现一个简单的长期记忆DEMO
实现一个简单的长期记忆DEMO
要理解智能体的长期记忆,可以先看两个问题:一轮对话结束后,系统怎样判断哪些信息值得留下;之后遇到相关问题时,又怎样把这些信息找回来。本文通过一个 Java Demo 展开这两个环节:回答完成后,模型提出记忆操作候选,由 Java 程序校验并保存;下一轮提问时,程序检索相关记忆,连同近期对话一起提供给模型。
一、长期记忆在 Demo 中保存什么
Demo 把长期记忆按用户归属,使用 userId 区分不同用户;同一用户的记忆可以在不同 threadId 会话中召回。短期对话消息仍按 userId + threadId 隔离。
long_term_memories
├─ id                记忆 ID
├─ user_id           记忆所属用户
├─ memory_type       semantic / episodic / procedural
├─ content           记忆正文
├─ source_thread_id  来源会话
└─ updated_at        最近更新时间
三类记忆分别用于保存事实、经历、偏好或规则。这里的重点是长期记忆的管理流程;数据库保存完整记录,而本轮只把检索到的少量候选交给模型。
二、从问答到长期记忆变更:整体流程
关键边界:提取模型只返回候选 JSON,不直接连接数据库。Java 应用负责检查候选并执行存储操作;提取调用失败不会撤销已经生成并保存的本轮回答。
三、模型提出的操作 JSON
extractMemoryOperations() 把提取规则、近期用户发言和最多 100 条已有记忆交给模型,请它返回以下结构。Assistant 的回复不会被当作用户事实。
{
  "operations": [
    {
      "action": "ADD",
      "type": "procedural",
      "content": "用户偏好简洁的中文回答,少用术语。",
      "target_id": null,
      "confidence": 0.96
    }
  ]
}
| 字段 | 含义 | 示例或规则 |
|---|---|---|
action | 模型建议执行的动作 | ADD、UPDATE、DELETE、IGNORE |
type | 记忆类别 | semantic 事实、episodic 经历、procedural 偏好或规则 |
content | 精炼后的记忆正文 | 新增或更新后要保存的内容 |
target_id | 待更新或删除的已有记录 ID | ADD 通常为 null;UPDATE、DELETE 指向已有记录 |
confidence | 模型按提示给出的自评数值 | 当前程序忽略低于 0.85 的候选;不是校准概率 |
四、applyMemoryOperations():校验后再执行
该函数位于 LongTermMemoryDemo.java。它接收提取模型的 JSON、当前用户和线程信息、最新用户消息以及提取前的记忆快照,返回成功变更的条数。
- 读取 operations:如果缺少操作数组或结构不正确,则不修改记忆。
- 过滤:置信度低于 0.85 或动作为
IGNORE时直接跳过。 - 处理 DELETE:最新用户消息必须包含明确的遗忘意图;目标 ID 还必须存在于当前用户的记忆快照中。
- 验证内容:ADD 和 UPDATE 的记忆类别必须有效;正文长度为 4–400 个字符,且不能命中敏感信息检查。
- 执行 ADD:调用
upsertMemory()写入;数据库用用户、类别和正文的唯一约束避免重复。 - 执行 UPDATE:目标记录必须属于当前用户,且类别匹配,然后调用
updateMemory()。 - 执行 DELETE:调用
deleteMemory(userId, id);SQL 同时限定用户 ID 和记忆 ID。
DELETE 的额外保护:即使模型返回了 DELETE 候选,代码仍会检查最新用户消息是否明确要求忘记,避免模型单方面删除记忆。
五、长期记忆的查询与手动管理
自动召回
每次普通提问时,findRelevantMemories(userId, question, 5) 先从当前用户的记录中取候选,按关键词重合数量由高到低排序;同分时优先较新记录,最多取 5 条。命中的记忆加入 system 提示,近期对话则以各自的 role 加入请求消息。
这版是轻量关键词检索:中文用相邻双字作为检索词,英文按单词匹配。它不是向量检索,面对同义改写时可能漏召回;数据库中的完整记忆仍保留。
用户命令
| 命令 | 行为 | 相关存储函数 |
|---|---|---|
/memories | 列出当前 userId 的全部长期记忆及来源线程。 | listMemories(userId) |
/forget <记忆ID> | 删除当前用户指定的记忆;不属于当前用户的 ID 不会删除。 | deleteMemory(userId, id) |
| 普通问题 | 自动检索相关记忆并将少量结果提供给模型。 | findRelevantMemories(...) |
六、Demo 和实际项目的差距
这个 Demo 把长期记忆的核心闭环放在一个 Java 程序里,便于看清每一步由谁负责。真正上线后,数据量、用户规模和可靠性要求都会提高,因此下面这些地方通常还需要进一步设计。
1. 记忆提取会增加一次模型调用
Demo 在每次成功问答后同步调用提取模型。这样流程直观,但用户需要多等一次模型响应,也会增加 API 成本;若提取接口故障,记忆本轮就没有更新。实际系统可以把提取工作放到后台队列异步执行,配置重试和失败告警,同时确保主问答不被拖慢。
2. 模型给出的 confidence 不能当作真实概率
这里的 confidence 是模型根据提示自行生成的分数,0.9 并不代表经过统计校准后有 90% 的正确率。Demo 用阈值做一层简单筛选;生产系统还应结合明确的规则校验、来源证据、冲突检测,必要时对高风险记忆要求用户确认,并通过评估数据检查误写和漏写。
3. 关键词检索的语义能力有限
当前实现把问题和记忆拆成词,再按重合数量排序,优点是逻辑简单、结果容易解释,也不需要额外的 Embedding 调用。但“别太啰嗦”和“回答简洁”可能用词不同却意思接近,关键词检索未必能匹配。记忆数量或问法变化增多时,可考虑全文检索与向量检索混合召回,再重排候选,并用检索评估集验证效果。
4. 自动写入需要完整的记忆生命周期管理
只把内容写进去还不够:重复记忆要合并,用户更正要处理旧值与新值的冲突,过时信息要能更新或过期,用户要求遗忘时也要确保真正删除。Demo 只用有限规则演示这些动作;实际项目通常还要记录来源和更新时间,制定保留策略,并提供查看、纠正、删除和审计能力。
5. 存储与权限要适应真实部署
SQLite 适合单机学习 Demo,数据量和并发上升后,生产服务一般会考虑集中式数据库、备份恢复、迁移和并发控制。每次读取、更新或删除都必须校验用户身份和数据归属;敏感信息还需要明确的保存范围、访问控制和删除策略,不能只依赖模型提示词来保护。
总结
通过这个 Demo,可以看到长期记忆并不是把所有旧对话一股脑交给模型。每次提问时,程序先从属于当前用户的记忆中找出少量相关内容,和近期对话一起提供给回答模型;回答完成后,再由提取模型判断用户这轮有没有表达值得以后保留的信息。
提取模型给出的只是操作建议。是否新增、更新或删除,最终由 Java 程序依据规则和用户归属进行检查,再写入 SQLite。这样,模型负责理解内容,应用负责把关并管理数据。
这版实现用关键词排序和简单校验展示了基本思路。真实项目还需要随着用户规模和使用要求,逐步完善记忆检索、异步提取、数据治理、权限与评估。理解这个基本闭环后,我们就有了继续改进长期记忆系统的起点。
实现一个简单的短期记忆DEMO
实现一个简单的短期记忆DEMO
短期记忆让应用能在同一段会话中接续上下文。实现的核心很直接:按会话标识保存消息,每轮请求时取出对应历史交给模型。但当会话越来越长,系统还需要决定带哪些内容、如何控制长度,以及怎样压缩较早的对话。
一、短期记忆在程序里是什么
短期记忆可以理解为一条会话线程的持续状态。应用用 threadId 标识会话,把用户消息和模型回复按先后顺序保存;下一轮再取回同一线程的历史,让模型获得这段对话的背景。
要区分两件事:数据库里保存的完整历史,和本轮实际发送给模型的上下文。历史可以长期保存在本地;每次请求只需选取适合当前问题、且不超过预算的部分。
数据库记录的基本结构
messages 表保存每条消息的线程 ID、角色、正文和时间;按 thread_id 与消息顺序查询。不同线程的数据不会混在一起。
messages
├─ id          消息顺序
├─ thread_id   会话标识
├─ role        user / assistant
├─ content     消息正文
└─ created_at  保存时间
Demo 还提供切换线程、列出线程、查看当前历史、清空当前线程等命令。模型调用成功后,应用在同一事务中保存本轮的用户问题和助手回答,避免只保存半轮对话。
本节 Demo 的代码位于 Gitee 仓库的 Page7 目录:https://gitee.com/toxplore/ai/tree/master/Page7。程序默认将数据库保存在 data/short-term-memory.db。
二、Demo 完整流程图
下面的流程图对应 Page7 中的 Java 程序:从启动配置和 SQLite 初始化,到每轮问答、命令处理,以及 thread 之间的隔离与恢复。
1. 启动:准备会话消息存储
图较宽时可横向滚动查看。
SQLite 在这个 Demo 中负责持久保存会话消息。模型不直接访问数据库;Java 应用负责按 threadId 读取和写入。
2. 普通问答:读取历史、请求模型、保存本轮
注意:Demo 在模型成功返回后才调用 saveTurn()。如果 API 报错,本轮用户问题不会写入 SQLite;此前成功的轮次仍保留。
3. Thread 命令:切换、查看或清空会话
/thread <会话ID>switchThread() 验证 ID,并读取历史条数;main 更新当前 ID。实际历史会在下一次普通提问时重新加载。
/memoryprintMemory() 调用 loadMessages(),打印当前 thread 的消息。
/threadsprintThreads() 调用 listThreads(),列出已有消息的 thread ID。
/resetclearThread(threadId) 只删除当前 thread 的消息。
/quitmain() 结束交互循环;SQLite 中已保存的会话仍保留。
4. 记忆隔离与持久化
三、会话变长后会遇到什么问题
| 问题 | 为什么会发生 | 可能的影响 | 解决方案 |
|---|---|---|---|
| 上下文窗口有限 | 每轮把全部历史重新发送,消息会不断累积。 | 请求可能超出模型限制;即使没超限,也会增加输入 token、成本和响应时间。 | 用模型对应的 tokenizer 估算 token;预算中先扣除系统提示、当前问题、工具定义、回答空间和余量。超出阈值时压缩较早消息,只发送“摘要 + 最近几轮原文 + 当前问题”。 |
| 历史噪声变多 | 已结束的话题、重复内容和临时细节仍在历史中。 | 模型可能被无关背景分散注意力。 | 围绕当前任务挑选上下文:保留任务目标、已确认决定、约束、待办和近期对话;不相关的旧话题不放进本轮请求,需要时再从完整历史查回。 |
| 简单截断会丢重点 | 只保留最近几轮,可能删掉更早但仍有效的决定、偏好或任务目标。 | 模型忘记约束,或重复询问已经确认的信息。 | 截断前先把较早消息整理成结构化摘要,保留目标、决定、偏好和未完成事项;完整原文继续存储,并记录摘要覆盖到哪条消息,便于回查。 |
| 摘要可能失真 | 模型归纳时可能遗漏细节、混淆时间顺序,或把推测写成事实。 | 后续回答依赖错误或过时的摘要。 | 采用增量摘要(旧摘要 + 新一段历史),要求区分讨论、决定和完成;只记有依据的内容,冲突标为待确认。校验摘要格式并保留原文和消息位置。 |
| 线程和隐私管理 | 线程标识使用错误会读错会话;历史也可能包含敏感信息。 | 上下文串线,或不必要地保留、发送敏感内容。 | 查询始终按已验证的 threadId 限定,并检查用户是否有权访问该线程;发送模型前按策略过滤敏感信息,支持清理或删除过期会话。 |
四、怎样从历史中挑出有用上下文
筛选要围绕当前问题和当前任务来做,而不是把历史越多越好。一个可解释、容易调试的第一版,可以把上下文拆成三部分:
任务摘要
目标、已确认决定、约束、进度、待办,以及仍有效的用户偏好。
近期原文
最近几轮完整消息,保留当前话题的细节、措辞和问答衔接。
再加上系统提示和当前问题,组成发给模型的本轮上下文。完整历史仍留在 SQLite,需要时可以按线程回查。
- 先保留系统提示、当前问题和最近几轮对话。
- 加入仍有效的目标、决定、约束、进度和待办。
- 若仍超预算,再压缩较早的消息;重复、无关或已被新决定替代的内容可省略。
- 新信息与旧信息冲突时,以用户明确更新的内容为准;无法判断时标记待确认。
五、长度控制与摘要如何配合
先计算本轮可用预算
输入可用预算
  = 模型上下文上限
  - 预留的回答空间
  - 安全余量

历史可用预算
  = 输入可用预算
  - 系统提示、工具定义、当前问题及其他输入
实际 token 数应使用对应模型或服务提供的统计能力估算。字符数不能准确替代 token 数;API 返回的用量适合事后校准,发送前仍要做预算控制。
超过阈值时压缩较早消息
常见实现是直接调用大模型做摘要,或采用增量摘要:将旧摘要 + 新发生的一段较早消息交给模型,让它生成更新后的摘要。程序负责触发时机、选择消息范围、保存摘要和校验长度;模型负责理解并归纳内容。
触发条件:历史 token 估算超过阈值
      ↓
选取较早的一段消息
      ↓
旧摘要 + 这段消息 → 摘要模型
      ↓
保存新摘要与已覆盖的消息位置
      ↓
本轮上下文 = 摘要 + 最近消息 + 当前问题
摘要保留什么
| 字段 | 要记录的内容 | 示例 |
|---|---|---|
| 当前目标 | 仍在进行的任务 | 实现 Java 短期记忆 Demo |
| 已确认 | 明确决定或已经采用的方案 | SQLite 按 threadId 保存消息 |
| 进度与待办 | 已完成事项、下一步和未解决问题 | 基础会话已完成;待实现上下文裁剪与摘要 |
| 偏好与事实 | 仍有效的用户要求和必要的具体信息 | 函数需要注释;百炼额度错误码 |
摘要更新时应要求模型只记录消息明确支持的内容,区分“讨论过、已决定、已完成”,保留必要的数字、路径和错误码;冲突标为待确认。保存时可以记录摘要覆盖到哪条消息,避免重复摘要或漏处理消息。
摘要不是原始记录的替代品。完整消息保留在数据库,摘要只是给模型快速提供背景。摘要可能有损;若任务需要精确措辞、时间线或证据,应从原始历史回查。
总结
短期记忆让应用能够按会话保存并恢复交互历史。每轮请求时,应用取出当前线程的历史,与用户的新问题一起组成上下文交给模型;模型返回后,应用再保存本轮问答。随着历史增长,系统需要在 token 预算内筛选上下文:保留当前任务相关信息和近期原文,把较早对话压缩为可校验的摘要,同时保留完整历史供后续回查。
智能体记忆系统:短期记忆与长期记忆
智能体记忆系统:短期记忆与长期记忆
这节我们参考 LangChain 的 Memory 概念文档,梳理智能体记忆系统,包括短期记忆和长期记忆,并进一步了解不同类型的长期记忆及其管理方式。

在 LangChain Memory 一文中,Memory 被定义为一个用来记住先前交互信息的系统。对智能体来说,记忆不仅帮助它接续之前的对话,也能让它利用反馈、适应用户偏好。接下来我们就从它按回忆范围划分的两类记忆开始了解。
先给记忆系统一个定义
智能体的记忆系统,是一套在交互过程中保存、组织和取回信息的机制。它通过短期记忆维持当前会话的连续性,并通过长期记忆让有用的信息跨会话保留;在需要时,系统将相关记忆提供给大语言模型,用于生成回应或完成任务。
因此,记忆系统不只是数据库。它还涉及信息筛选、结构组织、检索、更新和过期清理。LLM 可以帮助提取或整理记忆,但应用需要管理保存范围、读写时机和数据校验。
两种记忆范围:短期与长期
短期记忆:跟随当前会话
短期记忆通常保存同一个会话线程(thread)中的消息历史和任务状态。一个 thread 可以看作一条独立的对话线;它不必等同于浏览器窗口或标签页,具体由应用如何分配会话 ID 决定。
在 LangChain Memory 一文中,短期记忆是 Agent state(状态)的一部分,并可通过与 thread 关联的 checkpointer(检查点机制)持久化。状态除聊天消息外,也可以包含任务进度、上传文件、检索结果或工具调用结果。恢复同一个 thread 时,应用可以读取相应状态继续处理。
检查点机制可以理解为在会话处理过程中,为某个 thread 的 state 保存一份带有标识的进度快照。后续请求带上同一个 thread ID 时,系统就能读取最近保存的检查点,恢复这条会话的消息和任务状态;如果程序中断,也可以从已保存的状态继续。它保存的是应用状态,不是让 LLM 自己记住内容。
同一 thread 的消息与任务状态
          ↓
      Agent state
          ↓
   checkpointer 持久化
          ↓
  后续请求恢复同一 thread
对话历史会不断变长。把全部历史都塞进每次模型请求,可能超过上下文窗口,还会增加耗时和成本,并让旧的无关内容干扰当前任务。应用可以保留最近几轮、总结较早内容,或按任务筛选仍有用的状态。
长期记忆:跨会话保留
长期记忆保存用户或应用层面的信息,可以跨不同会话线程使用。例如,“用户偏好中文解释”可以在之后的新对话中取回。与当前会话的短期记忆不同,长期记忆关注的是哪些信息值得跨会话保留,并在之后的交互中按需取用。
长期记忆不是把全部历史永久放进提示词。系统会针对当前请求查找相关记忆,只把需要的信息提供给模型。还应考虑用户隔离、权限、信息更新和删除。
长期记忆可以保存什么?
LangChain 文档借用三种常见记忆类型来描述长期记忆的内容。它们不是和“短期、长期”互斥的另一套存储,而是回答“记忆里保存什么”。
| 类型 | 保存内容 | 智能体例子 |
|---|---|---|
| 语义记忆 | 事实与概念,记“知道什么” | 用户偏好中文回答 |
| 情景记忆 | 过去的事件或行动,记“经历过什么” | 某次任务怎样查询并核对订单 |
| 程序记忆 | 规则与做事方法,记“应该怎么做” | 客服处理退款前先核对政策 |
例如,“用户喜欢 Java 示例”是事实,属于语义记忆;“上次成功处理某个退款问题的步骤”是一次经历,可作为情景记忆;“退款前必须检查政策”是规则,可作为程序记忆。
注意:语义记忆(semantic memory)和语义搜索(semantic search)不是一回事。前者是所保存的记忆内容类型;后者是按照含义相似度查找信息的一种检索方法。
语义记忆的两种组织方式
语义记忆常保存用户、组织或其他对象的事实。LangChain 文档举出两种管理形态:集中维护一份 Profile,或把记忆拆成多个独立条目的 Collection。
Profile:更新一份档案
Profile 通常是有明确字段的 JSON 文档。系统把旧档案和新对话交给模型,让模型提出更新后的档案或 JSON Patch,再由应用校验并保存。
{
  "preferred_language": "中文",
  "example_language": "Java",
  "answer_style": "简洁"
}
优点是整体画像集中,取用方便;随着字段增多,合并新旧信息时更容易遗漏或错误覆盖,因此需要明确 schema(数据结构)并进行校验,也可以按主题拆分档案。
Collection:维护一组记忆条目
Collection 是一组持续添加、更新或删除的独立记录。每条可以有自己的结构和元数据,例如内容、来源、创建时间和适用用户。
[
  {"fact": "用户偏好中文回答", "type": "preference"},
  {"fact": "用户正在学习 RAG", "type": "learning_goal"},
  {"fact": "示例项目使用 Java", "type": "project_context"}
]
这种方式便于单条新增和检索,但需要处理重复、冲突、更新与删除;条目分散也可能让模型缺少它们之间的整体关系。使用 Collection 时,检索逻辑和记忆维护规则尤其重要。
可以这样选择:需要一个稳定、整体的用户画像时,Profile 较直观;信息来源多、条目持续增长且需要逐条搜索时,Collection 更灵活。系统也可以组合两者,例如用 Profile 保存当前偏好,用 Collection 保存具体经历。
情景记忆:用过去的例子帮助当前任务
情景记忆保存过去发生的事件或 Agent 的行动。在一些任务中,系统可以把成功的输入与输出保存为示例,再根据当前输入选择相似示例,作为 few-shot prompting(少样本提示)的一部分。
过去的案例:用户问订单进度 → 查询订单状态 → 用简洁语言说明
当前的问题 → 找到相关案例 → 把示例放进提示词 → 模型参考示例处理
关键不是把所有历史案例都交给模型,而是按当前输入挑选有帮助的例子。案例需要维护和评估,避免错误或过时的做法被反复模仿。
程序记忆:维护做事规则
对智能体来说,程序记忆可以体现在模型权重、Agent 代码和提示词中。通常由开发者控制代码与模型配置;应用也可以根据反馈改进提示词或规则。
例如,客服 Agent 的操作规则可以是:先确认用户身份,再查询订单;涉及退款时核对政策;信息不足时先向用户追问。系统可把近期反馈和旧指令交给模型,生成一版候选指令,但应经过审核或自动校验后再启用,不能把一次性要求误当作永久规则。
长期记忆何时更新?
记忆写入可以放在处理用户请求的主流程中,也可以放到后台异步执行。选择取决于信息是否需要立即生效,以及当前响应能否接受额外延迟。
| 方式 | 流程 | 特点 |
|---|---|---|
| 主流程即时更新 | 收到消息 → 更新记忆 → 回复用户 | 新记忆较快可用;增加本次响应耗时 |
| 后台异步更新 | 收到消息 → 回复用户 → 后台整理并写入 | 用户等待更短;新记忆稍后才可用,后台失败需重试或监控 |
例如,用户刚刚更正自己的语言偏好。如果下一轮请求必须立即使用新偏好,可以在主流程更新;如果记忆整理较慢且不影响当前回答,可以先回复,再异步写入。后台图示里的时间延迟只是说明处理可以稍后发生,并非固定等待时间。
设计时先回答四个问题
- 记什么? 区分当前任务状态、用户事实、历史经历和长期规则,避免把所有消息都当成记忆。
- 何时写? 决定在请求主流程即时写入,还是交给后台异步整理。
- 怎样取? 根据 thread、用户、任务、关键词或语义相关性,挑选当前真正有用的记忆。
- 何时更新或删除? 处理偏好变化、事实冲突、过期信息、用户撤回和数据保留期限。
短期记忆的重点是让当前任务接得上;长期记忆的重点是留下跨会话仍有价值的信息。两者一起工作,才构成可持续使用的智能体记忆系统。
延伸阅读
- LangChain:Memory 概念概览,介绍短期/长期记忆及语义、情景、程序记忆。
- LangGraph:短期记忆,介绍 thread state 与 checkpointer。
- LangGraph:长期记忆,介绍 Store、namespace、Profile 与记忆读写。
- CoALA:Cognitive Architectures for Language Agents,从认知架构角度讨论语言智能体的记忆、行动和决策过程。
实现一个简单的工具调用DEMO
实现一个简单的工具调用DEMO
本文围绕 Page9 的 Java Demo,梳理一个工具调用程序从启动、注册工具到处理模型请求并返回结果的整体设计。重点放在各个组件如何衔接,以及应用怎样控制工具的校验和执行。
一、程序设计整体流程图
先从程序运行顺序看整体结构。启动时,应用创建工具定义并注册到 Agent;每轮交互中,模型可以直接回答,也可以请求调用工具。工具结果回到模型后,流程继续循环。
注册表是流程的起点:应用启动时创建工具定义,交给 Agent 按名称保存。此后同一份注册表既用于向模型提供候选,也用于应用查找模型请求的本地执行函数。
二、按流程拆解关键设计
1. 定义工具:把说明和 Java 执行函数绑定
每个 ToolSpec 包含工具名称、用途说明、参数 JSON Schema 和本地执行函数。Demo 定义了计算器和本机日期两个工具,前者接收算式,后者不需要参数。
工具定义 = 名称 + 用途描述 + 参数 Schema + Java 执行函数

calculator(expression: string)
get_current_date()
以计算器为例,工具名 calculator 与 Java 函数 Calculator.calculate(...) 在注册时绑定。模型只看到工具说明和参数定义,不会拿到这个 Java 函数。
2. 注册工具:应用维护唯一的工具表
程序启动时把工具列表传给 Agent。Agent 按工具名把它们放入 Map<String, ToolSpec>,形成注册表;重复的工具名会被拒绝。这个表有两个用途:提供本轮候选,以及在模型提出调用后查找对应的本地执行函数。
3. 提供候选:把工具定义放进模型请求
每轮调用模型时,程序从注册表取出可用工具列表。百炼适配器将每个工具转换为 Chat Completions 的 tools 项,包含 name、description 和 parameters,并设置 tool_choice 为 auto,表示让模型自行判断是否需要工具。
{
  "type": "function",
  "function": {
    "name": "calculator",
    "description": "计算只包含数字、括号和 + - * / 的算式。",
    "parameters": {
      "type": "object",
      "properties": { "expression": { "type": "string" } },
      "required": ["expression"],
      "additionalProperties": false
    }
  }
}
这是模型可见的“工具菜单”。参数 Schema 告诉模型要提供怎样的输入,也供应用在执行前校验参数。
4. 读取模型响应:判断是否调用以及调用什么
程序读取 choices[0].message.tool_calls。如果没有工具调用,模型返回的文本就是最终答复;如果有调用,程序解析每项中的工具名、参数和调用 ID。
{
  "tool_calls": [{
    "id": "call_abc123",
    "type": "function",
    "function": {
      "name": "calculator",
      "arguments": "{\"expression\":\"123 * 456\"}"
    }
  }]
}
| 返回字段 | 应用怎样使用 |
|---|---|
function.name | 作为注册表查找键,决定请求哪个本地工具。 |
function.arguments | 解析为参数对象,校验后传给执行函数。 |
id | 作为 call_id 保存,之后用于关联工具结果。 |
5. 应用校验并执行:模型请求不等于允许执行
runTool() 先检查调用 ID,再按工具名在注册表查找。未注册的工具不会执行。找到工具后,validateArguments() 根据 Schema 检查必填字段、额外字段和基础类型;校验通过才调用注册时绑定的 Java 函数。
模型提出
“调用 calculator,参数是 expression=123*456。”这是调用请求,不是 Java 命令。
应用执行
查到注册项、校验参数后,应用调用 Calculator.calculate() 并取得结果。
未知工具、参数校验失败或执行过程发生异常时,程序不会把请求当成任意函数执行;它会生成一段错误结果,让模型知道本次工具调用没有成功。
6. 返回结果:用 tool_call_id 对应原调用
执行结果被包装成一条 role=tool 消息,并带回原来的调用 ID。这样模型能知道结果对应哪一次工具请求。
{
  "role": "tool",
  "tool_call_id": "call_abc123",
  "content": "56088"
}
应用把这条消息追加到对话历史,再次请求模型。模型可以根据结果继续提出下一项工具调用,也可以直接组织最终答复。若一轮返回多个工具调用,程序会分别执行,并用各自的 tool_call_id 返回结果。
三、关键代码位置
| 流程环节 | 关键实现 |
|---|---|
| 工具定义 | ToolSpec、CALCULATOR、CURRENT_DATE |
| 建立工具注册表 | Agent 构造函数按工具名保存定义 |
| 提供候选工具 | Agent.run()、toApiTools()、DashScopeModel.complete() |
| 解析模型调用 | parseApiReply() 生成 ToolCall |
| 校验与执行 | runTool()、validateArguments()、ToolExecutor.execute() |
| 把结果交回模型 | Message.toolResult()、toApiMessages()、Agent.run() 下一轮循环 |
四、运行 Demo
先运行离线模式,可以在不调用模型 API 的情况下观察程序闭环。离线模型会固定模拟一次计算器调用;它不会根据你输入的问题进行推理。
cd "D:\data\ai学习\ai\Page9"
mvn compile exec:java "-Dexec.args=--demo"
体验模型实际选择工具时,在 PowerShell 中设置百炼 API Key 和控制台里可用的模型名,再启动真实模式:
$env:DASHSCOPE_API_KEY = "你的百炼 API Key"
$env:DASHSCOPE_MODEL = "控制台中可用的模型名"
mvn compile exec:java
可以尝试“计算 123 × 456”“今天的日期是什么”或分成多步的算式。终端会显示提供给模型的候选工具、模型的调用请求、应用执行结果和后续模型轮次。输入 /reset 清空本次进程内对话,输入 /quit 退出。
五、Demo 与实际项目
这个 Demo 把工具调用核心闭环压缩在一个 Java 文件中,便于沿着数据流学习。实际项目的工具不一定是本地计算函数,也可能连接其他子系统的 API、企业服务或操作系统能力。变化的是工具背后的执行方式,整体闭环仍然相同。
调用其他子系统的 API
例如把订单查询封装为 get_order_status(orderId)。模型提出调用后,应用检查工具是否已注册、参数是否有效,以及当前用户是否有权查看该订单;随后由 Java API 适配器调用订单子系统,把响应整理成适合模型读取的结果,再作为工具消息交回模型。Java 可以用 HttpClient 发送 HTTP 请求,也可以使用目标系统提供的 SDK。
模型请求 get_order_status(orderId)
    ↓
应用校验工具、参数与用户权限
    ↓
Java API 适配器请求订单子系统
    ↓
整理响应并关联 tool_call_id
    ↓
结果交回模型
API 密钥和服务凭据由应用在服务端安全保存并附加到请求中,不应放进提示词或让模型生成。生产代码还要处理超时、服务错误、限流和重试;对可能重复产生副作用的请求,需要设计幂等保护。
调用操作系统工具
应用也可以把有限的系统能力包装成工具,例如查询磁盘空间、读取允许目录中的文件列表。能用 Java 标准库完成时,优先直接调用 Java API;确实需要启动外部程序时,可使用 ProcessBuilder,并由应用限定可运行的程序和参数。
不要开放一个让模型传入任意命令字符串的通用执行入口。应使用名称明确、范围有限的工具,校验每个参数,并设置执行超时、工作目录、输出大小和操作系统权限;高影响或不可逆操作还应要求用户确认。
系统和工具变多后使用 MCP
当需要连接多个独立服务时,可以通过 MCP 等协议统一工具的发现和调用。MCP Server 暴露工具名称、说明和输入 Schema,客户端先获取可用工具,再通过 tools/call 请求执行;这能统一连接方式,但不会自动替代应用的身份认证、授权和业务校验。可参考 MCP 工具规范。
共同的控制边界:模型负责提出调用请求;应用或工具服务负责身份认证、授权、参数校验和实际执行。按最小权限开放工具,对删除、付款、发送消息等高影响操作增加确认、限流和审计。OWASP 将过多功能、权限或自主性带来的风险称为 Excessive Agency,参见 OWASP LLM06:2025。
当前 Demo 的 JSON Schema 校验只覆盖必填字段、额外字段和基础类型,并不是完整的 Schema 校验器。实际项目还要按具体 API 和系统能力补齐业务规则、权限检查、失败处理、超时、重试、审计和并发控制。
最重要的设计边界是:模型能够提出工具调用,但应用保留工具注册、权限校验和执行控制权。无论工具在本机、另一个子系统,还是 MCP Server 后面,应用都应在执行前做自己的检查。
总结
用户提出问题后,应用先把注册好的工具说明和对话一起交给模型。模型若返回调用请求,应用就按工具名查注册表、校验参数并运行对应的 Java 函数;工具结果带着原 call_id 回到对话中,模型再决定继续调用还是回答用户。
因此,工具调用不是模型直接执行本地代码,而是一种由模型提出请求、应用受控执行、模型读取结果并继续处理的协作闭环。Page9 的计算器和日期工具,就是这套机制的最小可运行例子。
理解智能体中的工具调用
理解智能体中的工具调用
上一篇《从最小 Agent 看懂工具、检索与记忆》里,我们用一个计算器认识了工具调用的基本闭环:模型提出调用请求,Java 程序执行函数,再把结果交回模型。
这个例子只有一个计算器。真实应用可能有查询订单、查库存、退款、发邮件等许多工具。工具多起来以后,问题就不只是“怎么调用”,还包括“工具怎样定义”“本轮把哪些工具交给模型”“程序怎样安全地执行”。本文结合 OpenAI Function Calling 指南,把这些问题连起来说明。
一、工具调用是什么,基本过程怎样实现?
先从一个简单例子理解工具调用,再逐步拆解模型和应用各自负责什么。下面五点回答两个基础问题:工具调用是什么?一个工具调用从定义到执行、回传结果,程序要怎样完成?
第一点:工具调用到底是什么?
先用一个天气查询例子说明。用户问:
“今天杭州天气怎么样?”
假设应用提供了一个天气工具 get_weather(city)。模型不会自己打开天气网站,而是根据问题和工具说明,判断需要查询天气,并提出类似“调用 get_weather,参数 city=杭州”的结构化请求。应用收到后才调用天气服务,再把天气数据交回模型组织答案。
用户问天气
   ↓
应用把问题和“天气工具说明”发给模型
   ↓
模型决定调用 get_weather(city="杭州")
   ↓
应用执行天气查询
   ↓
查询结果返回给模型
   ↓
模型整理成自然语言答复
关键在于:模型提出调用请求,应用或工具服务才真正执行。模型通常不会自己连接天气网站;它会返回“请调用 get_weather,参数是杭州”这样的结构化请求。应用收到后,才运行对应函数并把结果交回模型。这个“定义工具—接收调用请求—执行—回传结果”的交互方式,可以对照 OpenAI 工具调用流程理解。
先认识 5 个基本概念
| 概念 | 在天气例子里是什么 |
|---|---|
| 工具 | 查询天气的能力,例如 get_weather |
| 工具定义 | 告诉模型工具叫什么、能做什么、需要哪些参数 |
| 调用请求 | 模型提出调用 get_weather,并传入 city="杭州" |
| 工具执行 | 应用真正查询天气服务 |
| 工具结果 | 天气服务返回的数据,再交给模型组织答案 |
因此,工具调用不是“模型说要查天气,天气就自动出现”。应用必须接收调用请求、执行工具,并把结果传回模型。
第二点:LLM 在工具调用中做什么?
LLM 根据用户任务、对话上下文和应用提供的工具定义,判断是否需要使用工具;如果需要,就选择工具并生成参数。收到工具执行结果后,LLM 再判断信息是否足以回答,还是需要继续调用其他工具。例如天气查询失败后,它可以根据返回的错误决定重试、换用其他工具或说明暂时查不到;查到天气后,也可以继续查询空气质量。
因此,LLM 负责判断下一步并生成调用请求,不负责实际运行工具。应用负责接收请求、校验参数与权限、调用对应函数,并把结果交回 LLM。LLM、应用和工具共同组成的系统才是 Agent;Agent 的完整行为不等同于 LLM 单独的行为。
第三点:用户、应用、模型和工具怎样配合?
以“今天杭州天气怎么样?”为例,可以沿着四个参与方看完整过程。应用是中间的协调者:它把问题和天气工具定义发给模型,接住模型的调用请求,执行天气查询,再将结果交回模型并把最终答案发给用户。
第四点:模型返回的调用请求长什么样?
模型不会把“我正在查天气”当作普通回答交给应用,而是返回一条机器可以读取的结构化调用项。OpenAI Responses API 的 function call 会带有调用标识、函数名称和参数。下面是简化示意:
{
  "type": "function_call",
  "call_id": "call_abc123",
  "name": "get_weather",
  "arguments": "{\"city\":\"杭州\"}"
}
name告诉应用要找哪个工具处理器。arguments是模型按工具参数定义生成的输入;应用需要解析并校验它。call_id用来将这次请求和稍后返回的工具结果对应起来。
字段形式会随 API 模式或服务商改变;核心信息是“调用哪个工具、参数是什么、这次调用的标识是什么”。这条数据是待执行请求,不是天气结果,也不是一段应该直接展示给用户的最终答案。
第五点:应用怎样执行调用并把结果交回去?
应用通常维护一个工具注册表,把每个工具名称映射到本地处理器。例如 get_weather 映射到天气服务客户端。处理器接收解析后的参数,执行相应操作,并将结果转成简洁、明确的文本或 JSON。
调用请求 name = get_weather
        ↓
工具注册表查找 get_weather 对应的处理器
        ↓
解析 arguments,校验 city 参数和访问权限
        ↓
调用天气服务,得到天气数据
        ↓
组成 tool result,并保留 call_id
天气服务返回数据后,应用再把结果作为对应调用的输出消息交回模型。Responses API 的消息大致如下:
{
  "type": "function_call_output",
  "call_id": "call_abc123",
  "output": "{\\"location\\":\\"杭州\\",\\"temperature_celsius\\":20}"
}
这里的 call_id 与模型原先返回的调用请求相同,用来让 API 知道这是哪一次调用的结果。output 可以是 JSON、普通文本或错误信息;应用随后再次请求模型,模型根据工具结果生成面向用户的答复,或提出下一次工具调用。
实现时的重要边界:不要把模型返回的工具名直接当成任意 Java 方法名去执行。应用应使用明确的白名单映射(例如 switch 或工具注册表)分发请求;未注册的工具名直接拒绝。调用请求仍须经过参数校验、权限检查,以及必要的用户确认。
二、实际项目中,工具多了怎么办?
理解基本调用闭环后,实际系统还要面对规模和业务复杂度:用户的问题属于哪个领域?本轮应该开放哪些工具?工具达到数百或上千个时,怎样避免全部发送给模型?下面讨论这些落地问题。
第六点:工具很多时,每轮提供哪些工具?
如果只有天气查询、计算器等少量工具,应用可以把这些工具定义一起发给模型,让模型根据问题决定是否调用以及调用哪一个。工具达到几十、几百甚至上千个时,通常不会把完整清单每轮都发送;工具说明会占用上下文,候选过多也会增加选错的机会。
常见做法是先由应用缩小范围,再由模型做具体选择。应用可以结合用户原话、当前页面、业务对象和权限信息,先判断业务类别;例如“退款进度”进入支付/退款工具组,“某商品还有库存吗”进入商品/库存工具组。接着,只把这一组里可授权的少数候选工具交给模型。
场景判断可以使用固定规则、页面入口、分类器或轻量模型。类别明确时规则简单可靠;表达方式多时,可以让分类模型从预设类别中选择。类别不确定时可放宽候选集合或追问。无论模型把请求分到哪个场景,最终权限检查仍由应用执行。
第七点:1000 个工具要一起发给模型吗?Tool Search 怎么做?
通常不需要。可以先建立工具目录,保存每个工具的名称、用途描述、所属领域、参数摘要和权限信息;请求到来时,应用先按场景和权限过滤,再用关键词或向量搜索从描述中找出少量候选工具。
OpenAI Function Calling 指南还介绍了 Tool Search:初始请求不必暴露所有低频工具,模型可以先搜索工具目录,找到相关工具后再加载其定义并调用。截图所示指南注明,内置 tool_search 的支持范围以文档列出的模型为准,页面标明 GPT-5.4 及之后的模型支持。其他模型/框架也可以通过应用侧的工具目录检索实现类似的按需发现流程。
大量工具目录(不全部发给模型)
          ↓ 按上下文、场景、权限过滤
本轮候选工具(仍过多时继续检索)
          ↓
模型从候选中选择 / 按需 Tool Search
          ↓
应用校验并执行所选工具
第八点:框架可以替我们做哪些事?
工具调用可以手写,也可以用框架减少重复工作。框架通常帮助注册工具、生成工具定义、解析模型调用请求、分发到处理器、回传结果并继续模型循环;它不会自动理解企业业务,也不会替应用决定用户权限。
- LangChain4j:Java 框架。可用
@Tool描述方法,也可通过ToolProvider按请求动态提供工具;官方工具文档还包括面向大工具集的搜索机制。 - Spring AI:适合 Spring 应用,可用
@Tool或 ToolCallback 暴露 Java 方法,并用 ChatClient 管理常见的调用往返。
对于学习和小规模 Demo,先看清自己写出的“请求—调用—执行—回传”最容易理解;业务复杂、需要动态工具、错误恢复和观测时,再让框架接管通用环节。
总结:工具调用的完整闭环
工具调用过程
定义工具 → 根据场景与权限提供候选工具 → 模型选择并提出调用 → 应用校验并执行 → 结果回到模型 → 模型继续回答或调用下一项工具
用户提出任务后,应用整理可信上下文,并把适合本轮且有权限的工具定义提供给模型。模型判断直接回答还是提出结构化调用请求;应用解析请求、校验参数与权限,执行对应工具,再把结果和调用标识交回模型。Agent 根据结果决定继续调用、换工具、追问、转人工或结束。模型最终给出答复,应用再返回给用户。模型负责提出行动并根据观察结果决策,应用负责授权、执行和控制整个调用边界。
参考:OpenAI Function Calling 指南、LangChain4j Tools、Spring AI Tool Calling。
如何让 RAG 系统更可靠地找到所需资料
Page6 · RAG 学习笔记
如何让 RAG 系统更可靠地找到所需资料
上一篇《一个DEMO认识最小RAG》里,我们从一个最小向量 RAG Demo 出发,编写了基本流程。
资料切块并向量化准备可检索的资料索引
→
问题转成向量使用同一个嵌入模型
→
余弦相似度检索排序并取 Top K 片段
→
生成回答把问题和命中片段交给模型
这条流程构成了最小 RAG 的基础。接下来,我们继续看一个实际问题:当简单的向量检索没能稳定找到所需资料时,可以怎样改进?查询改写、复杂问题拆解、混合检索和重排序分别处理不同环节,检索评估则帮助判断改动是否有效。
四种改善检索的方法
1. 查询改写:让搜索词表达得更清楚
用户的提问可能很口语、依赖上下文,或者没有包含资料里的关键词。查询改写会在保持原意的前提下,把问题整理成更适合搜索的完整表达。
例子:对话中用户问“那酒店呢?”,系统可以结合前文改写成“公司差旅政策对酒店住宿报销有什么规定?”。这样检索时不必猜“酒店”指什么。
适合:问题简短、指代不清、上下文省略,或用户用词与资料用词不同的情况。改写后仍然是同一个查询意图。
技术实现思路
- 在调用现有
retrieve()前,增加rewriteQuery(question, history)。这个函数通过聊天 API,把当前问题和必要的最近对话发送给同一个大语言模型。 - 在这次 API 请求的提示词中,明确要求模型只返回一个独立、明确的检索问题,并保留人名、产品名、编号、日期和数字,不要补造用户没说过的条件。
- 用改写后的问题做检索,但最终生成回答时仍传入用户的原问题和检索片段。
- 如果改写为空、超时或格式异常,就回退到原问题,保证检索主流程可以继续。
// rewriteQuery 内部调用聊天 API,返回模型改写后的检索问题
String searchQuery = rewriteQuery(question, recentHistory);
List<Hit> hits = retrieve(searchQuery, chunks);
// 回答仍使用用户原问题,并附上检索到的资料
String answer = askModel(question, formatContext(hits));
LangChain4j 中可用查询转换组件处理这一步,例如把依赖对话上下文的追问压缩成独立查询。组件负责组织流程,具体改写仍由所配置的模型完成。
2. 复杂问题拆解:分别搜索问题中的多个方面
一个问题如果同时询问多个对象、条件或步骤,单次搜索可能只照顾到其中一部分。拆解会把它转成多个独立、完整的子问题,分别检索,再把证据合并起来回答原问题。
例子:“比较 Milvus 和 PostgreSQL 做混合检索时的检索能力、改造成本和运维成本”,可以拆成检索能力、接入现有 Demo 的改造量、部署运维差异三个子问题。
与查询改写的区别:改写通常产生一个意思相同、表达更清楚的查询;拆解会产生多个不同但彼此相关的子查询,每个子查询负责找到原问题的一部分证据。
技术实现思路
- 先判断问题是否包含多个目标;可以用简单规则做初筛,再让模型输出结构化的子问题列表。
- 要求每个子问题脱离原句也能看懂,并限制数量,例如最多 3~5 个;简单问题就只返回原问题或一个改写问题。
- 相互独立的子问题并行调用检索;有先后依赖时按顺序检索。
- 把各路结果按片段 ID 去重,再用 RRF 等方式融合排名;最终用原始问题和合并后的证据生成回答。
List<String> queries = decompose(question); // 结构化子问题
List<List<Hit>> resultLists = retrieveInParallel(queries, index);
List<Hit> evidence = rrfMergeAndDeduplicate(resultLists);
String answer = askModel(question, formatContext(evidence));
LangChain4j 的 QueryTransformer 可以把一个查询转换成一个或多个查询;检索编排器再把多路结果交给聚合器。子问题并行会缩短等待时间,但会增加检索调用量。
3. 混合检索:同时照顾语义和关键词
向量检索擅长找到意思相近的内容;关键词检索擅长匹配产品型号、政策编号、人名等精确词语。混合检索把两种结果合并,减少只依赖其中一种方式带来的漏检。
例如搜索“报销上限”,语义检索可能找到标题为“差旅费用标准”的片段;如果用户问的是型号“X200”,关键词检索又能帮忙精确命中包含该型号的资料。
结果怎么合并?可以用 Reciprocal Rank Fusion(RRF)等方法综合不同检索列表的排名。直观地说,一个片段如果在多个列表里都排得靠前,合并后通常也会靠前。
技术实现思路
- 索引中同时保留片段原文和向量。检索时分别执行关键词检索(如 BM25)和向量检索,各自先取一批候选,例如各取前 20 条。
- 用 RRF 合并两个排名列表。对片段
d,累加它在各列表中的1 / (c + rank)分数;没出现的列表不计分。c是平滑常数。 - 按融合分数排序并去重,再交给后续重排序或直接取最终 Top K。
向量检索 Top 20 ─┐
                  ├─ RRF 合并、去重 ─→ 候选结果
BM25 检索 Top 20 ─┘
在我们当前的本地 Demo 里,可以先分别实现 vectorSearch() 和 keywordSearch(),再实现 rrfMerge()。生产环境可以把检索存储替换成支持混合检索的 Milvus,再通过 Java SDK 执行稠密向量和 BM25 搜索;Milvus 的混合搜索接口支持用 RRF 或加权排序器融合结果。LangChain4j 可以负责查询转换、检索器和结果聚合等流程编排,底层数据库仍由对应的存储连接器负责。
4. 重排序:把最相关的候选资料放前面
初次检索的目标是尽量找全候选资料;重排序则对候选结果逐条评估它们与当前问题的相关程度,再重新排列。之后系统只取前几段加入提示词。
比如初次检索拿到 20 段,重排序后把真正解释“酒店报销上限”的片段放在最前,而把只提到“差旅”的泛相关片段排后。
注意:重排序只能调整已经召回的候选项。如果正确资料根本没有进入候选列表,重排序无法把它找回来。
技术实现思路
- 先用向量、关键词或混合检索快速召回较宽的一批候选,例如前 20~50 段。
- 把原问题与每个候选片段一起交给重排序模型(常见做法是 Cross-Encoder / Reranker),让模型直接判断“这段资料对回答这个问题有多相关”。
- 按相关性分数重新排序,必要时设最低分阈值,再只取前几段(如 3~5 段)进入最终提示词。
候选片段 + 原问题
        ↓ Reranker 逐段打分
按相关性排序 → 过滤低分 → 取 Top K
LangChain4j 提供 ReRankingContentAggregator,可接入实现了 ScoringModel 的评分 / 重排序模型。RRF 与 Reranker 的工作不同:RRF 融合多个检索列表的名次;Reranker 再用查询与片段的匹配程度精排。重排序能提升精排质量,但会增加一次模型调用的延迟和费用,所以通常只处理有限候选集。
检索评估:检查系统到底有没有找对
检索评估主要用于离线检查和迭代,不是每次用户提问时必需的一步。先准备一组代表性问题,并由人标注每个问题应该命中的资料,再让系统检索,比较实际结果与标注结果。
| 指标 | 直白解释 | 常用于发现 |
|---|---|---|
| Recall@K | 应该找到的相关资料,有多少出现在前 K 条里? | 重要资料有没有漏掉 |
| Precision@K | 前 K 条结果中,有多少确实相关? | 结果里无关内容是否太多 |
| MRR | 第一条相关资料排得有多靠前? | 最有用证据是否容易被模型优先看到 |
例如,测试集标注了 2 段相关资料,系统返回前 3 段并命中其中 1 段,那么 Recall@3 = 1/2。如果最相关的资料排在第二位,那么该问题的 MRR = 1/2。
技术实现思路
- 给索引片段分配稳定 ID(例如来源路径加章节 / 片段标识),建立固定测试集;每项记录问题、应命中的片段 ID,以及可选的问题类型标签。
- 在固定语料和相同 Top K 下,批量运行检索,记录每个问题实际返回的片段 ID 和名次。
- 用人工标注的相关片段计算 Recall@K、Precision@K、MRR;对有多个相关片段且关心整体排序的场景,也可加 NDCG@K。
- 对比基线向量检索与“改写 / 拆解 / 混合检索 / 重排序”版本的分数,同时记录延迟和调用成本,查看具体失败案例。
{
  "question": "酒店住宿每晚最多能报销多少?",
  "relevantChunkIds": ["travel-policy#hotel-limit"]
}
对当前 Java Demo,第一版可以自己写一个离线评测入口:读取 JSON 测试集,调用 retrieve(),按相关片段 ID 计算指标并输出结果表。这样不需要先引入评估框架,也能直接比较每次检索改动的影响。以后如果需要评估最终回答的忠实度、相关性和引用质量,再引入 Ragas 等面向 RAG 的评测工具;评估框架不能替代高质量的人工测试集。
常见评估框架怎么选?
| 框架 / 平台 | 主要用途 | 适合什么情况 |
|---|---|---|
| Ragas | 面向 RAG 的评估库。提供 Context Precision、Context Recall 等检索相关指标,也有 Faithfulness、Response Relevancy 等回答评估指标。 | 希望用一套 RAG 指标检查检索上下文和最终回答;它以 Python 为主,Java 项目可导出评测数据后单独运行评估。 |
| LangSmith | 管理测试集、运行实验和对比版本,也能结合规则评估、人工标注或 LLM-as-judge。 | 需要持续记录调用过程、追踪失败案例,并比较不同模型、提示词或检索配置。 |
| Microsoft Foundry Evaluators | 提供 Document Retrieval 等 RAG 评估器;有人工相关性标签时可评估检索排名,没有标签时也可用模型评估检索上下文相关性。 | 系统已经使用 Microsoft Foundry,希望在该平台上运行和查看评测结果。 |
| LangChain4j | 主要用于 Java 应用中的 LLM 与 RAG 流程构建,包括查询转换、检索和结果聚合;评测指标可由应用自行实现或接入其他评估工具。 | Java 开发者希望在代码里组织 RAG 流程;不要把它与专门的 RAG 评估平台混为一谈。 |
对当前 Demo 的建议:先用 Java 自己计算 Recall@K、Precision@K 和 MRR,弄清“实际命中”和“人工标注”如何比较;之后若想同时评估上下文质量和答案忠实度,可以把同一份测试数据导出给 Ragas。若还需要管理多轮实验和线上运行记录,再考虑 LangSmith 这类平台。
评测集怎么准备?
- 收集真实用户可能会问的问题,覆盖常见问法和不同难度。
- 为每个问题标注应该命中的资料片段,或至少标注相关来源文件。
- 运行检索,记录候选结果、排名和分数。
- 计算指标,并抽查失败案例,判断是查询、召回还是排序出了问题。
- 调整一个环节后重新评测,比较改动前后的结果。
如果按来源文件而不是片段标注,指标只能反映“找对了来源”,无法精确判断是否命中了来源中的正确段落。随着评测成熟,可以逐步改为片段级标注。
把五项内容放回一张图里
| 方法 | 解决的问题 | 作用位置 |
|---|---|---|
| 查询改写 | 问题表达不清或缺少检索所需信息 | 搜索之前 |
| 复杂问题拆解 | 一个问题包含多个检索目标 | 搜索之前 |
| 混合检索 | 只用语义或只用关键词都可能漏掉结果 | 召回候选资料时 |
| 重排序 | 初次检索结果中相关资料排序不理想 | 初次召回之后 |
| 检索评估 | 不清楚系统是否找对、改动是否有效 | 离线验证与迭代 |
可以把前四项看作检索链路中的改进工具,把检索评估看作检查这些工具是否有效的反馈办法。系统不必无条件启用全部方法:简单问题可能只需原始查询和向量检索;问题有多个方面时再拆解;精确词和语义都重要时用混合检索;候选较多或顺序不理想时再重排序。
最重要的判断
检索的目标不是拿到最多资料,而是找到足以支撑回答的相关证据。
如果评估显示相关资料没有被召回,优先检查查询处理和召回方式;如果资料已经召回但排得靠后,再检查排序和重排序。这样才能针对实际问题改进,而不是盲目叠加技术。
如果评估显示相关资料没有被召回,优先检查查询处理和召回方式;如果资料已经召回但排得靠后,再检查排序和重排序。这样才能针对实际问题改进,而不是盲目叠加技术。
把方法串成一条检索链路
对于一条复杂查询,在线流程可以概括为:
查询改写 / 拆解
  → 每个查询分别执行向量检索 + BM25
  → RRF 合并并去重
  → Reranker 精排
  → 取 Top K 片段,与原问题一起交给生成模型
在 Java 项目中,这些组件可以按职责组合:LangChain4j 用于编排查询转换、多个检索器和结果聚合,并可接入重排序模型;Milvus 负责存储文本与向量,并执行向量和 BM25 检索,Java 应用可通过 Milvus Java SDK 或相应适配器调用;RRF 用于融合多个检索列表的排名;评测代码则读取带有相关片段标注的数据集并计算指标。LangChain4j 与 Milvus 的具体连接方式取决于所选版本和集成模块。学习阶段也可以先用 Java 自行实现这些步骤,再逐步替换为框架和数据库组件。
参考文档
实现一个最小的RAG
实现一个最小的RAG
这一小节,我们把之前的简单文本匹配检索升级为向量检索,并沿着代码看清楚:资料如何变成可检索的索引,问题如何找到相关片段,模型又如何根据这些片段组织答案。
本节 Demo 的代码位于 Gitee 仓库的 Page5 目录:https://gitee.com/toxplore/ai/tree/master/Page5
先看整体流程
RAG 可以拆成两个阶段:先为资料建立索引;收到问题后,再用索引找到相关资料并生成回答。
1准备资料索引读取、清理、切分、向量化
保存或复用本地索引
保存或复用本地索引
→
2检索相关片段把问题转成向量
相似度排序并取 Top K
相似度排序并取 Top K
→
3生成回答问题 + 命中片段
发送给聊天模型
发送给聊天模型
一、资料怎样变成索引
程序从 data/ 读取 Markdown、纯文本和结构较简单的 HTML 文件。读取时会做基础清理;HTML 会移除标签、脚本和样式。随后按段落切分,再调用嵌入模型把片段转换为数字向量。
嵌入模型和聊天模型分工不同。
text-embedding-v3 把文本转换成向量;聊天模型负责根据问题和检索资料生成自然语言答案。向量相似度比较由 Java 程序完成。Chunk 保存什么?
每个 Chunk 代表一个可检索片段,包含来源文件、片段正文和嵌入向量。List<Chunk> 就是这些片段组成的列表:
Chunk {
  source     // 来源文件,例如 data/RAG入门.md
  text       // 片段正文
  embedding  // 片段的嵌入向量
}
切分规则:先保留段落,太长再拆
splitIntoChunks() 先按空行识别段落,再尽量把相邻段落组合到不超过 CHUNK_SIZE = 420 个 Java 字符的片段里。只有单独一段已经超过这个长度时,才由 splitLongParagraph() 继续拆分,并让相邻片段重叠约 CHUNK_OVERLAP = 60 个字符。
因此 420 是这个教学 Demo 的示例参数,不是所有资料都适用的最佳值。现实项目会考虑标题、章节、句子等文档结构,并通过真实问题评估切分效果。
二、buildOrLoadIndex():复用缓存或重建索引
- 调用
loadDocuments()读取资料,并计算资料内容与嵌入模型的指纹。 - 如果没有强制重建,而且本地索引存在、模型和指纹都匹配,就调用
readChunks()从 JSON 恢复片段和向量。 - 如果缓存不存在或不匹配,就重新切分资料,并分批调用嵌入 API 生成向量。
- 调用
writeIndex()把片段、来源和向量写入index/vector-index.json,然后返回List<Chunk>。
启动时会不会处理全部资料?
当前 Demo 每次启动都会读取资料并计算指纹;若索引有效,就加载缓存,不会重新切分或向量化。资料一旦变化,则当前实现会重新建立全部资料的索引,还没有做增量更新。
当前 Demo 每次启动都会读取资料并计算指纹;若索引有效,就加载缓存,不会重新切分或向量化。资料一旦变化,则当前实现会重新建立全部资料的索引,还没有做增量更新。
图:buildOrLoadIndex() 的缓存复用与索引重建分支

三、interact():一轮提问如何流动
- 进入交互循环,等待并读取用户问题;
/quit退出,/reindex强制重建索引。 - 普通问题交给
retrieve(question, chunks)。 retrieve()调用embed(question)将问题转成向量,并遍历片段列表,逐一计算余弦相似度。- 检索结果按分数降序排列,返回
TOP_K = 3个片段。 interact()把问题、命中片段和来源拼成上下文;askModel()再连同系统提示词一起发给聊天模型。- 程序打印答案,并回到循环等待下一问。
图:interact() 调度输入、检索和回答的过程

余弦相似度比较什么?
它衡量问题向量和片段向量方向的接近程度。分数用于排序,不代表答案正确概率。
它衡量问题向量和片段向量方向的接近程度。分数用于排序,不代表答案正确概率。
TOP_K = 3 表示最终返回三个片段,不表示只比较三个片段。四、重要函数对照
| 函数 | 职责 |
|---|---|
loadDocuments() |
遍历资料目录并读取支持的文件。 |
htmlToText() |
移除 HTML 标签和脚本样式,整理文本。 |
splitIntoChunks() |
按段落组合文本片段。 |
buildOrLoadIndex() |
检查指纹,加载已有索引或重新构建。 |
embed() |
调用百炼嵌入 API,把文本转换为向量。 |
readChunks() / writeIndex() |
从本地 JSON 恢复索引,或保存新索引。 |
retrieve() |
嵌入问题、计算相似度、排序并选出 Top K。 |
cosineSimilarity() |
计算两个向量的余弦相似度。 |
interact() |
读取用户输入、调度检索与生成、打印回答。 |
askModel() |
把系统提示词、问题和检索上下文发送给聊天模型。 |
五、Demo 的边界与现实系统
现在的 Demo
本地 JSON 保存所有片段向量;每个问题会遍历全部片段算相似度。结构简单,便于看懂数据如何流动。
规模变大以后
通常用向量数据库或搜索引擎保存和索引向量,以近似最近邻等索引方法加速查找,并通过后台流程增量更新资料。
因此,目前的 retrieve() 是教学用的穷举比较:资料片段多时,计算和内存成本会增长。未来升级时,可以把本地列表扫描替换为向量数据库的 Top K 查询。
运行与观察
$env:DASHSCOPE_API_KEY = "你的百炼 API Key"
cd "D:\data\ai学习\ai\Page5"
mvn compile exec:java
- 首次建索引会调用嵌入 API;资料和模型未变化时复用本地索引。
- 每个问题会调用嵌入 API 生成问题向量,并调用聊天 API 生成答案。
- 输入
/reindex强制重建,输入/quit退出。
本节的核心认识
RAG Demo 不只是“把资料发给模型”:程序先准备可搜索的向量索引,再用问题从索引中挑出少数相关片段,最后把这些片段作为上下文交给聊天模型。嵌入模型负责表示文本,检索代码负责选片段,聊天模型负责组织回答。
RAG Demo 不只是“把资料发给模型”:程序先准备可搜索的向量索引,再用问题从索引中挑出少数相关片段,最后把这些片段作为上下文交给聊天模型。嵌入模型负责表示文本,检索代码负责选片段,聊天模型负责组织回答。
从资料到回答:理解 RAG 的完整流程
从资料到回答:理解 RAG 的完整流程
上一篇我们从一个最小 Agent 出发,认识了工具、检索和记忆。这次,我们聚焦其中的检索增强生成(Retrieval-Augmented Generation,RAG),从“什么时候需要它”开始,逐步看它怎样准备资料、检索内容、生成回答,并判断效果好不好。
本文参考 Microsoft Learn 的 RAG 基础概念单元整理。我们之前的 Java Demo 也会作为对照:它完成了文档切分和简单匹配,但还没有使用嵌入向量或向量索引。
先看整体流程
准备资料并建立索引 → 用户提问 → 检索相关片段 → 将片段加入提示词 → 模型生成回答 → 评估并持续改进
什么时候会用到 RAG?
判断什么时候需要 RAG,可以先看大模型自身的三类限制:
- 知识边界:模型不会自动知道企业内部资料、私有文档或刚刚上传的文件。
- 知识时效性:模型训练时学到的信息可能已经过时,也不一定包含最新制度、产品变化或业务数据。
- 可验证性:模型可能给出听起来合理的回答,却没有可靠来源支持,用户也难以核对依据。
当问题受到这些限制影响时,就可以考虑使用 RAG:先从可信、已授权且尽量保持最新的资料中检索依据,再让模型根据这些内容回答。例如员工问“海外出差住酒店最多能报销多少?”,系统先查公司的差旅制度,并在回答中提供可核对的来源。
如果只是简单常识或计算,模型本身就能可靠回答,通常没必要额外检索。RAG 也会增加数据准备、检索、延迟和费用。
RAG 的整体框架:三个核心步骤
RAG 可以概括为三个连续步骤:先检索相关资料,再把资料加入提示词,最后让大模型依据上下文生成回答。
第一阶段:准备资料,建立索引
检索只能找到已经整理并放进搜索系统的资料。正式回答问题前,RAG 系统需要先构建索引。这个阶段通常在资料新增或更新时运行。

1. 选择并处理数据来源
资料可以来自产品手册、制度、网页、数据库或客服工单。系统要加载内容、提取文字和结构,并清理重复页眉、导航文字等无关内容。还可以补充标题、来源链接、类别、更新时间和访问权限等元数据,方便后续筛选、追溯和权限控制。
资料质量会影响后面的检索和回答:重复、过时或互相矛盾的内容会让结果变差;权限信息也要保留,确保用户只检索到自己有权查看的资料。
2. 把文档切分成片段
文档通常太长,不能每次都整篇交给模型,因此会切成较小的文本片段(chunks)。片段要有足够上下文,同时聚焦在一个主题上。太大片段会带入无关内容、占用更多上下文;太小则可能把标题、定义或条件拆散。相邻片段有时会少量重叠,避免重要信息刚好落在切分边界两侧。
例如,差旅制度可以按章节切成机票、酒店、餐饮和市内交通。用户问酒店额度时,系统只需检索酒店相关片段,不必把整份制度都交给模型。
3. 生成嵌入向量
嵌入模型把文本转换成一组数字向量,用来表示文本的语义。意思相近的文字,即使使用不同的词,向量通常也更接近。比如“酒店住宿标准”和“住一晚最多能报多少”,用词不同但语义相近。
建立索引时,用嵌入模型处理文档片段;用户提问时,通常还要用同一个嵌入模型处理问题,再比较向量。嵌入模型负责把内容变成便于比较的向量,生成式大模型则负责根据提供的内容组织回答。
4. 建立并维护索引
索引或向量数据库保存文本片段、对应向量和元数据,供后续搜索。索引可以支持关键词检索、向量检索或两者结合的混合检索。新增资料要加入,已修改的内容要更新,失效的内容要移除,所以数据准备不是一次性的任务。
换嵌入模型或向量维度后,通常要重新生成文档向量并重建索引,保证文档和用户问题仍能在同一种向量表示下比较。
第二阶段:检索资料,生成回答
当用户提问时,RAG 应用会在运行时执行一条链路:

检索:找出够用的证据
使用向量检索时,系统会用与建索引时同类的嵌入模型,把用户问题也转换成向量,再和文档片段的向量比较。比如“海外会议住酒店能报多少”可能匹配标题为“国际住宿费用”的条款,即使用词不完全相同。
检索可以通过元数据过滤、混合检索和重新排序来改善。混合检索同时利用关键词匹配与语义相似;重新排序会把更相关的候选片段排在前面;限制结果数量,则避免把弱相关或重复内容都塞进提示词。
系统要找的不是最多的内容,而是足以支撑答案的最少资料。实际中通常先取前 K 条,再通过测试调整 K 值和分数门槛;相关度分数只是参考,并不自动保证答案完整。
增强提示词:把依据交给模型
应用会把系统规则、用户问题和检索片段组合起来,并要求模型依据所给资料回答;如果资料里没有答案,要说明证据不足;如果有来源信息,则附上出处。
一个简化的提示词
规则:根据下面的制度片段回答。若片段没有答案,请说明没找到依据。
问题:海外出差住酒店最多能报销多少?
资料:[差旅制度 / 海外住宿] 每晚最高报销 500 元。
检索到的文档是待参考的数据,不是新的系统指令。文档里可能出现“忽略之前规则”等文字,应用应明确要求模型不要让资料内容覆盖系统规则。
生成:给出有依据、可核对的回答
模型根据增强后的提示词生成回答。应用最好同时展示来源标题、章节或链接,让用户核对答案依据。这样的回答称为有依据的回答(grounded response),但不代表绝对正确:检索结果可能不完整,模型也可能误解资料,资料本身还可能过时。
当没有足够证据时,系统应承认没找到,而不是猜测。在医疗、法律、财务等高影响场景,还需要人工复核。
第三阶段:评估 RAG 是否有效
RAG 是一条由检索和生成组成的流水线。回答听起来流畅,并不能证明整个系统工作良好。评估时要分开检查:检索是否找对资料,以及模型是否正确使用资料。
评估检索
- 相关性:检索片段是否在回答问题?
- 覆盖度:完整回答所需的信息是否都找到了?
- 排序:最有用的片段是否排在前面?
- 权限与时效:用户是否有权看这些资料?资料是否仍有效?
如果正确资料没有被检索到,单纯修改生成提示词通常解决不了问题。应检查资料质量、切分边界、元数据、查询处理方式、检索策略和排序。
评估生成
- 有依据:回答中的每个关键说法都能在资料中找到支持吗?
- 相关与完整:是否直接回答问题,并覆盖必要信息?
- 引用质量:引用的来源是否确实支持对应说法?
- 合理表达不确定性:资料不足时是否避免猜测?
自动系统怎样评估?
系统不会凭感觉知道答案好不好。通常需要先准备一组代表性测试问题,为每题标记正确来源片段和可接受答案,再自动记录检索结果和模型回答。规则检查适合金额、编号等明确字段;另一个模型也可以按标准评估回答是否有依据、是否完整。
例如问“海外住宿额度是多少”,如果测试集中标注的正确来源是《差旅制度》的“海外住宿”章节,就可以检查这段是否出现在前几条检索结果中。若检索正确、回答却把 500 元说成 800 元,问题可能出在生成;若正确条款没找到,则先排查检索。
“回答符合检索资料”不一定等于“事实正确”,因为来源自身也可能错或过期。高影响场景需要可信参照和人工抽查。
平衡质量、延迟与成本
检索并处理更多片段,可能提高信息覆盖度,但也会增加提示词长度、响应时间和费用。内容太多还可能让模型难以聚焦。因此要通过评估找到适合当前场景的检索数量、排序和提示词设置,而不是默认片段越多越好。
上线后持续观察用户哪些问题没答上、引用是否可靠、检索是否变慢,以及知识资料是否过期。资料、模型、提示词或检索参数变化后,都应重新评估。
回到我们的 Demo
之前的 Java Demo 从 HTML 中提取文本、切成片段,并用字符相似度为片段打分,再把匹配结果和问题一起发给模型。这展示了 RAG 的基本思路,但还没有使用嵌入模型或向量索引。
如果继续升级,可以先替换字符匹配:用嵌入模型分别处理文档片段和问题,再用向量相似度检索;随后添加来源元数据、混合检索、重排序和自动评估。每次升级都用同一组测试问题比较,才能知道改动是否真的有效。
本篇要点
RAG 的核心不只是“把资料塞给大模型”,而是把资料准备好、在问题到来时找对证据、让模型依据证据回答,再用系统化测试持续检查检索和生成的效果。
参考资料
Microsoft Learn:Introduction to retrieval-augmented generation concepts
Microsoft Learn:RAG evaluation guidance
理解智能体中的五种Workflow
理解智能体中的五种Workflow
上一篇我们从一个最小 Agent 出发,认识了模型、工具、检索和记忆。这次,我们再往前一步,看看当任务变复杂时,程序可以怎样组织模型调用。
当任务需要分几步完成时,程序可能会多次请求模型,并将每次结果传给后续步骤。一次这样的“请求—回答”就是一次模型调用(LLM Call)。
接下来介绍的五种工作流模式,关注的是如何组织这些调用:提示链、路由、并行化、编排者—工作者和评估者—优化者。它们也可以根据任务需要组合使用。
1. 提示链:按步骤依次完成
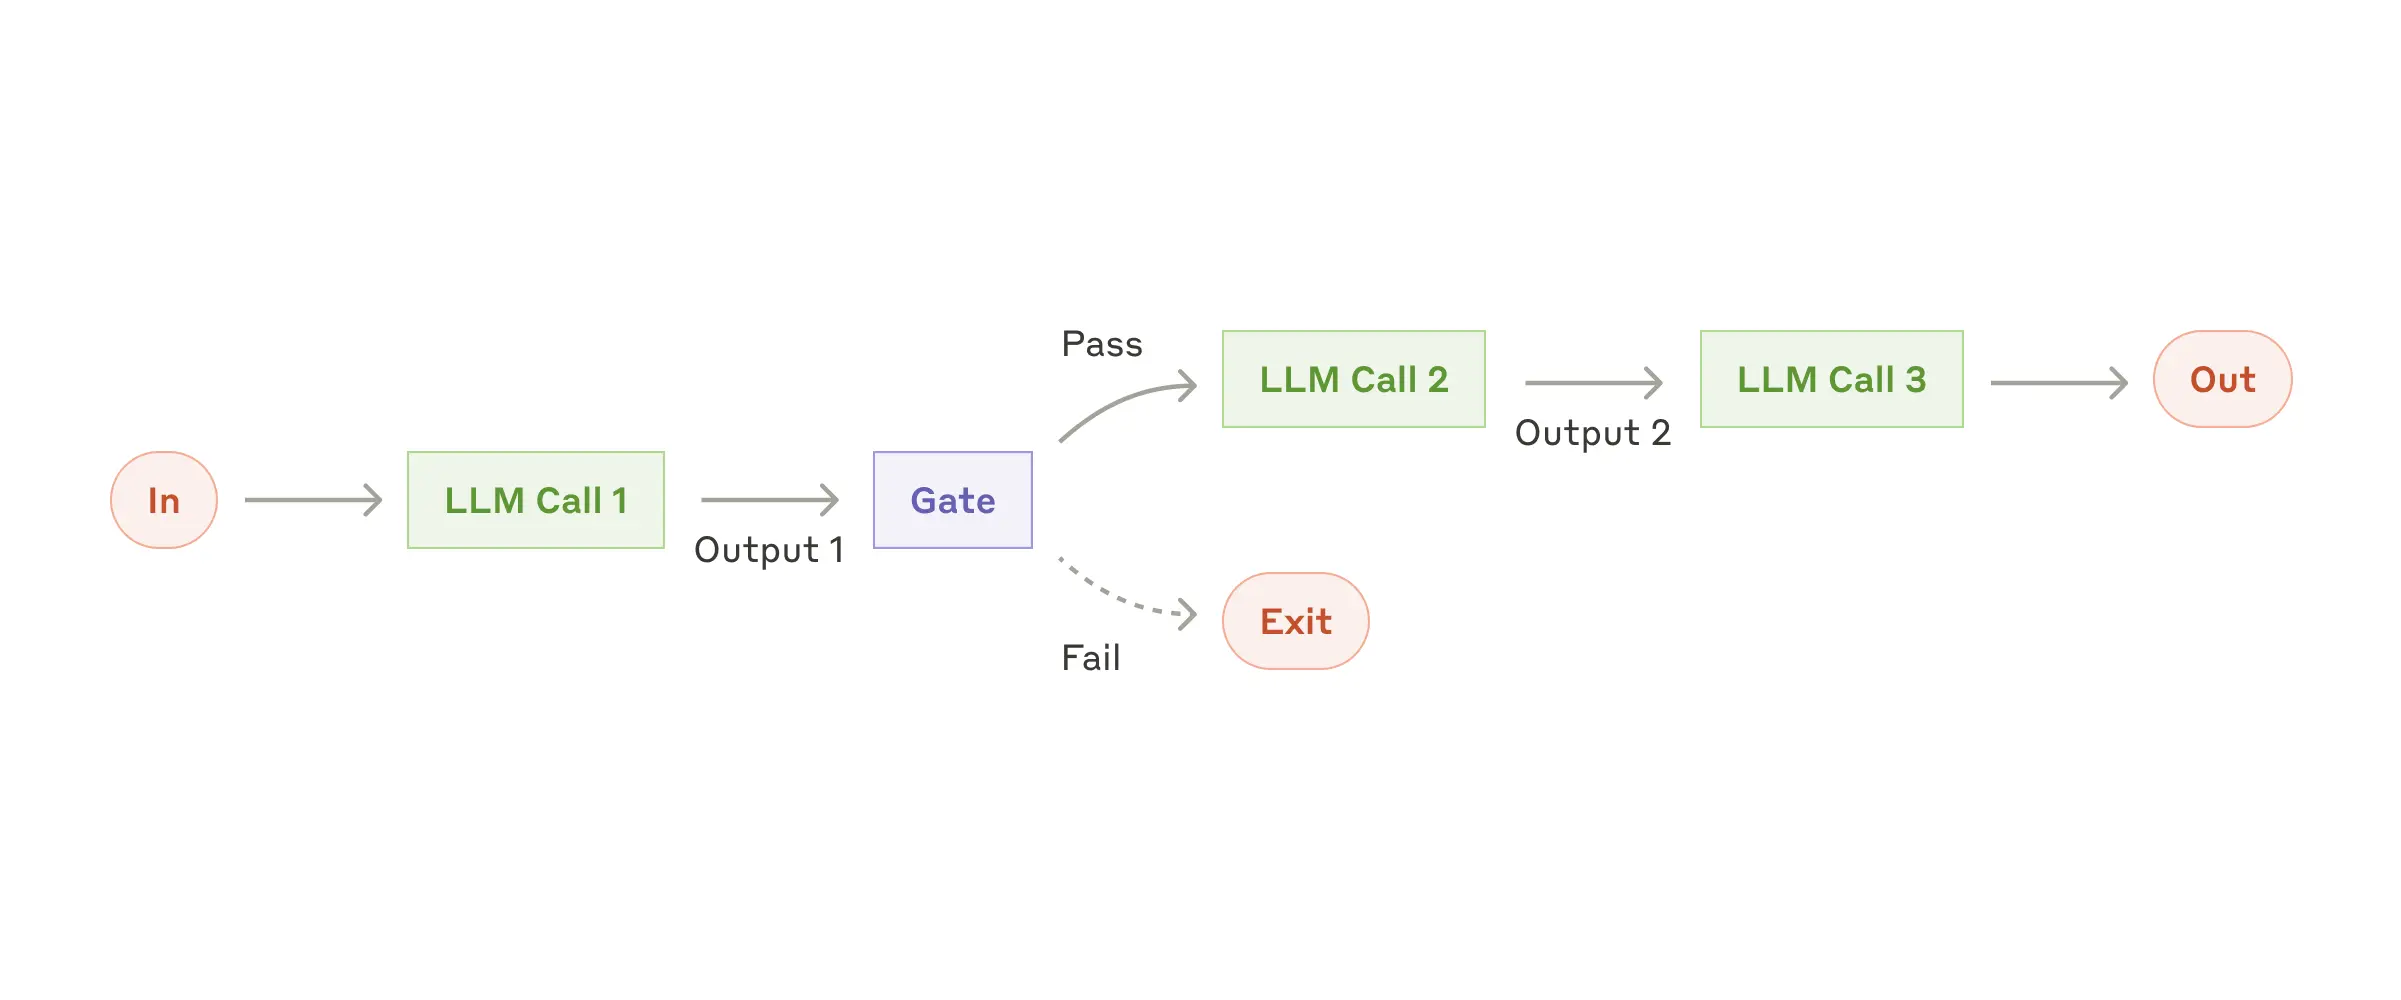
Prompt Chaining(提示链)把一个任务拆成固定顺序的步骤。前一步的输出成为后一步的输入,每次模型调用各自完成一个范围清楚的小任务。
用户输入
   ↓
LLM Call 1:生成文章提纲
   ↓
Gate:检查提纲是否覆盖必需章节
   ↓ 通过
LLM Call 2:根据提纲撰写正文
   ↓
输出文章
其中的 Gate(检查点)通常是程序执行的一条明确规则,例如字段是否齐全、格式是否有效、长度是否超限。检查失败时,程序可以停止、报错或安排重试。Gate 不一定是一次额外的模型调用。
提示链适合步骤和先后顺序都比较确定的任务,例如先生成营销文案再翻译,或先写提纲、检查提纲后再写全文。它让每一步更容易检查和调整,但需要多次调用模型,整体耗时也会增加。
2. 路由:先判断,再分流
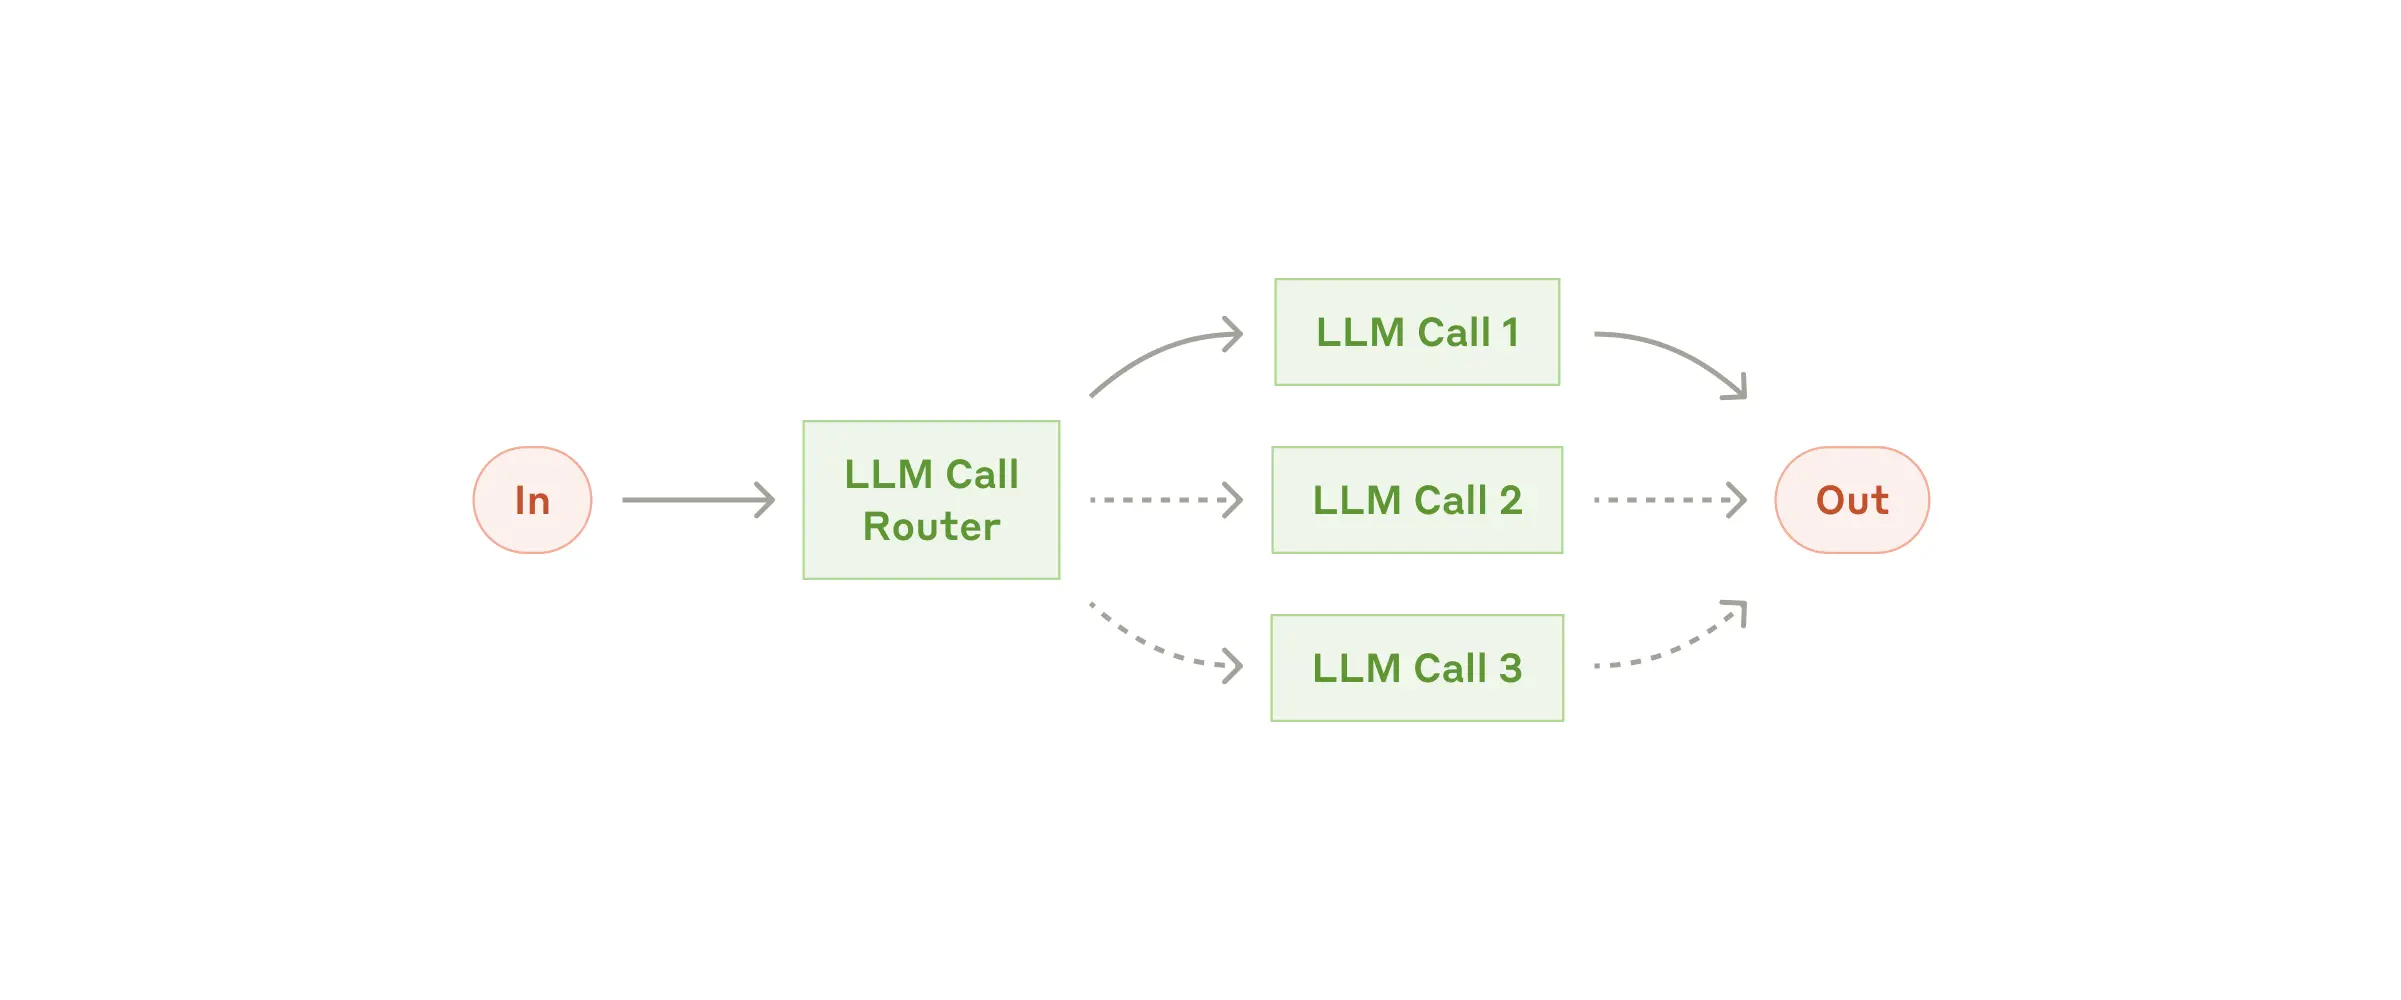
Routing(路由)先对输入分类,再把它送到最适合的后续任务。路由器可以是一次模型调用,也可以是规则或传统分类模型。
用户问题
   ↓
Router:识别问题类型
   ├─ 普通咨询 → LLM Call 1:知识问答
   ├─ 退款请求 → LLM Call 2:退款流程
   └─ 技术问题 → LLM Call 3:技术支持
                     ↓
                  返回结果
路由适合输入类别清楚、不同类别需要不同提示词、模型、工具或业务流程的场景,例如客服问题分流。它能让每个后续流程专注处理自己的任务;同时要考虑分类错误,并准备合适的兜底路径。
3. 并行化:同时处理,再汇总
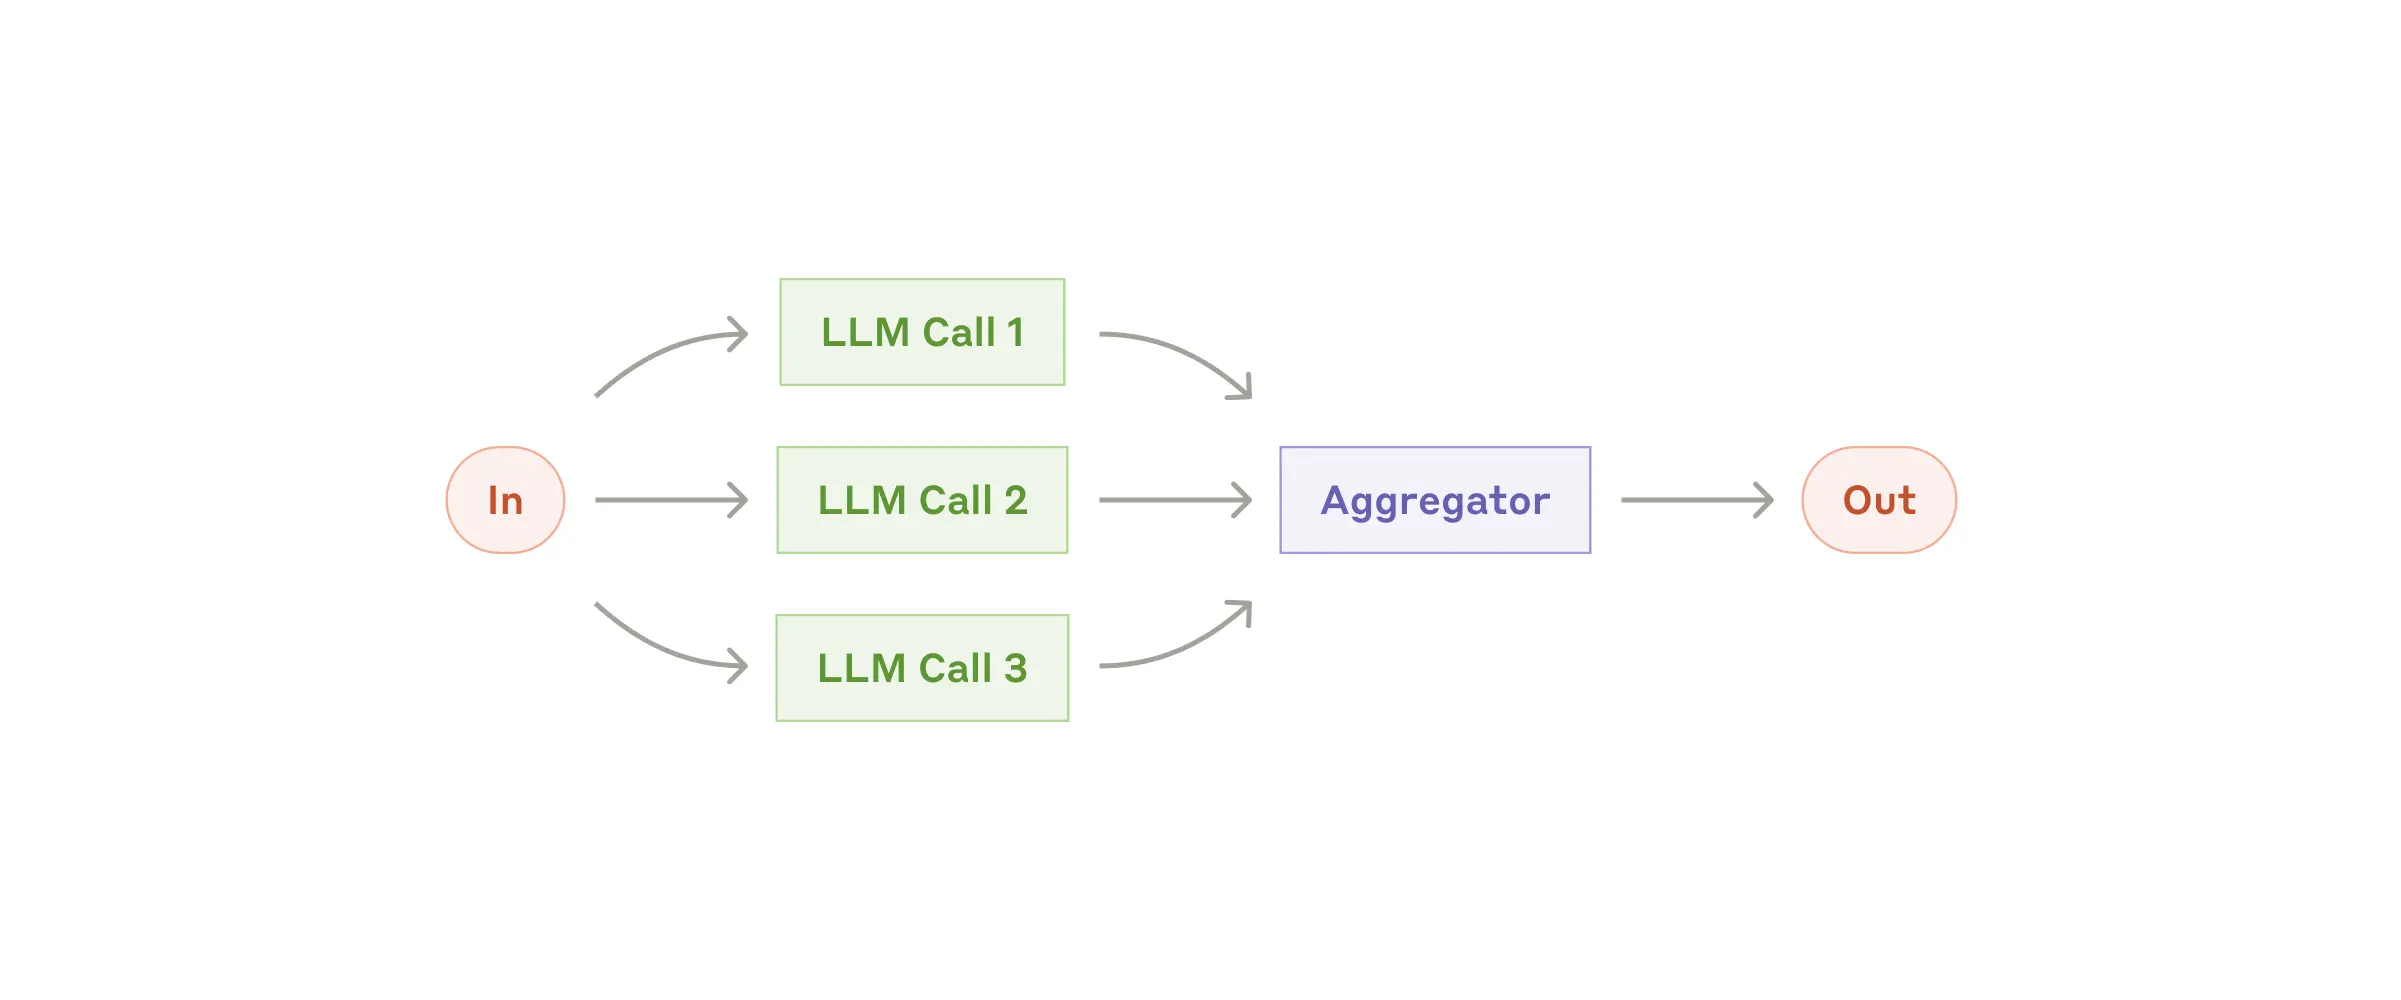
Parallelization(并行化)让多个模型调用同时工作,再由程序汇总结果。它有两种常见变体:分段和投票。
分段:分工做不同的事
程序把任务拆成彼此独立的部分,并行交给不同调用。例如审查代码时,一个调用检查安全问题,一个检查性能,另一个检查可读性,最后把发现合并。
投票:多次做同一件事
程序把同一个问题交给多个调用,让它们独立判断,再按照多数票、评分或阈值等规则综合结果。例如多个调用分别判断一段内容是否为垃圾信息,再由程序统计判断。
同一输入
   ├─ LLM Call 1 ─┐
   ├─ LLM Call 2 ─┼→ Aggregator:合并结果 → 输出
   └─ LLM Call 3 ─┘
程序通常会异步发出这些请求,再等待所需结果完成后汇总;也可以设置超时,或在达到票数后提前结束。并行化适合子任务互不依赖、需要缩短等待时间,或希望通过多次判断提高信心的情况。它会增加模型调用量,汇总规则也需要设计清楚。
4. 编排者—工作者:动态拆解和委派
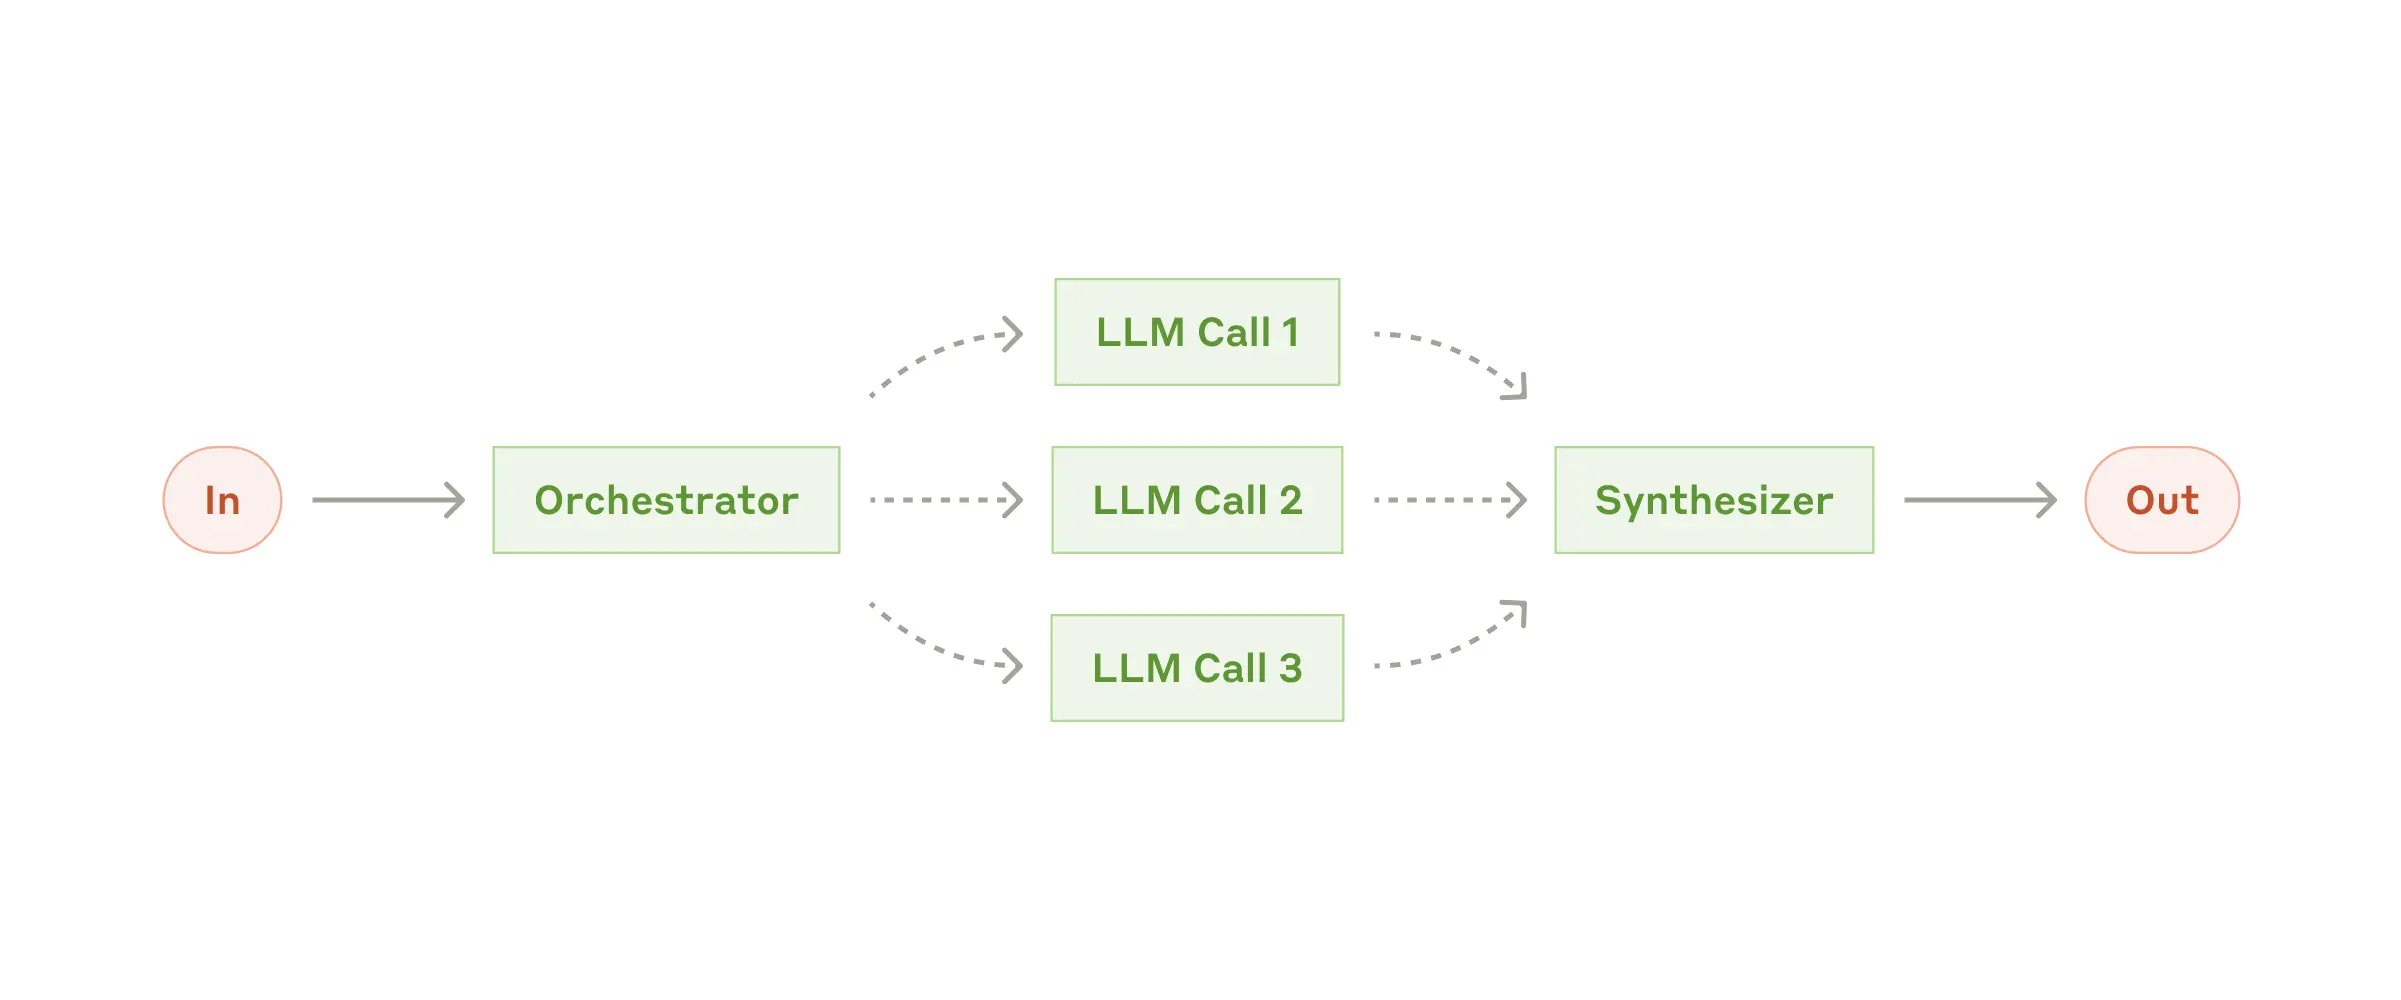
Orchestrator-Workers(编排者—工作者)适合任务复杂、开始时难以预先列出所有子任务的情况。一个中心模型先分析输入,动态拆解任务并分派给工作者,最后综合结果。
用户的复杂任务
   ↓
Orchestrator:分析任务并安排工作
   ├─ Worker 1:完成子任务 A ─┐
   ├─ Worker 2:完成子任务 B ─┼→ Synthesizer:检查并整合 → 输出
   └─ Worker 3:完成子任务 C ─┘
例如,修改一个涉及多个文件的软件项目时,编排者可以先分析改动范围,再安排工作者分别处理接口、页面和测试。若这些子任务互不依赖,就可以并行;若后一步依赖前一步结果,编排者也可以安排顺序执行。
它和固定的并行分段不同:固定分段通常由程序事先规定工作内容;编排者—工作者则会根据具体输入决定需要拆出哪些工作。代价是编排和整合更复杂,也要防止重复、遗漏或互相冲突的结果。
5. 评估者—优化者:根据反馈反复改进
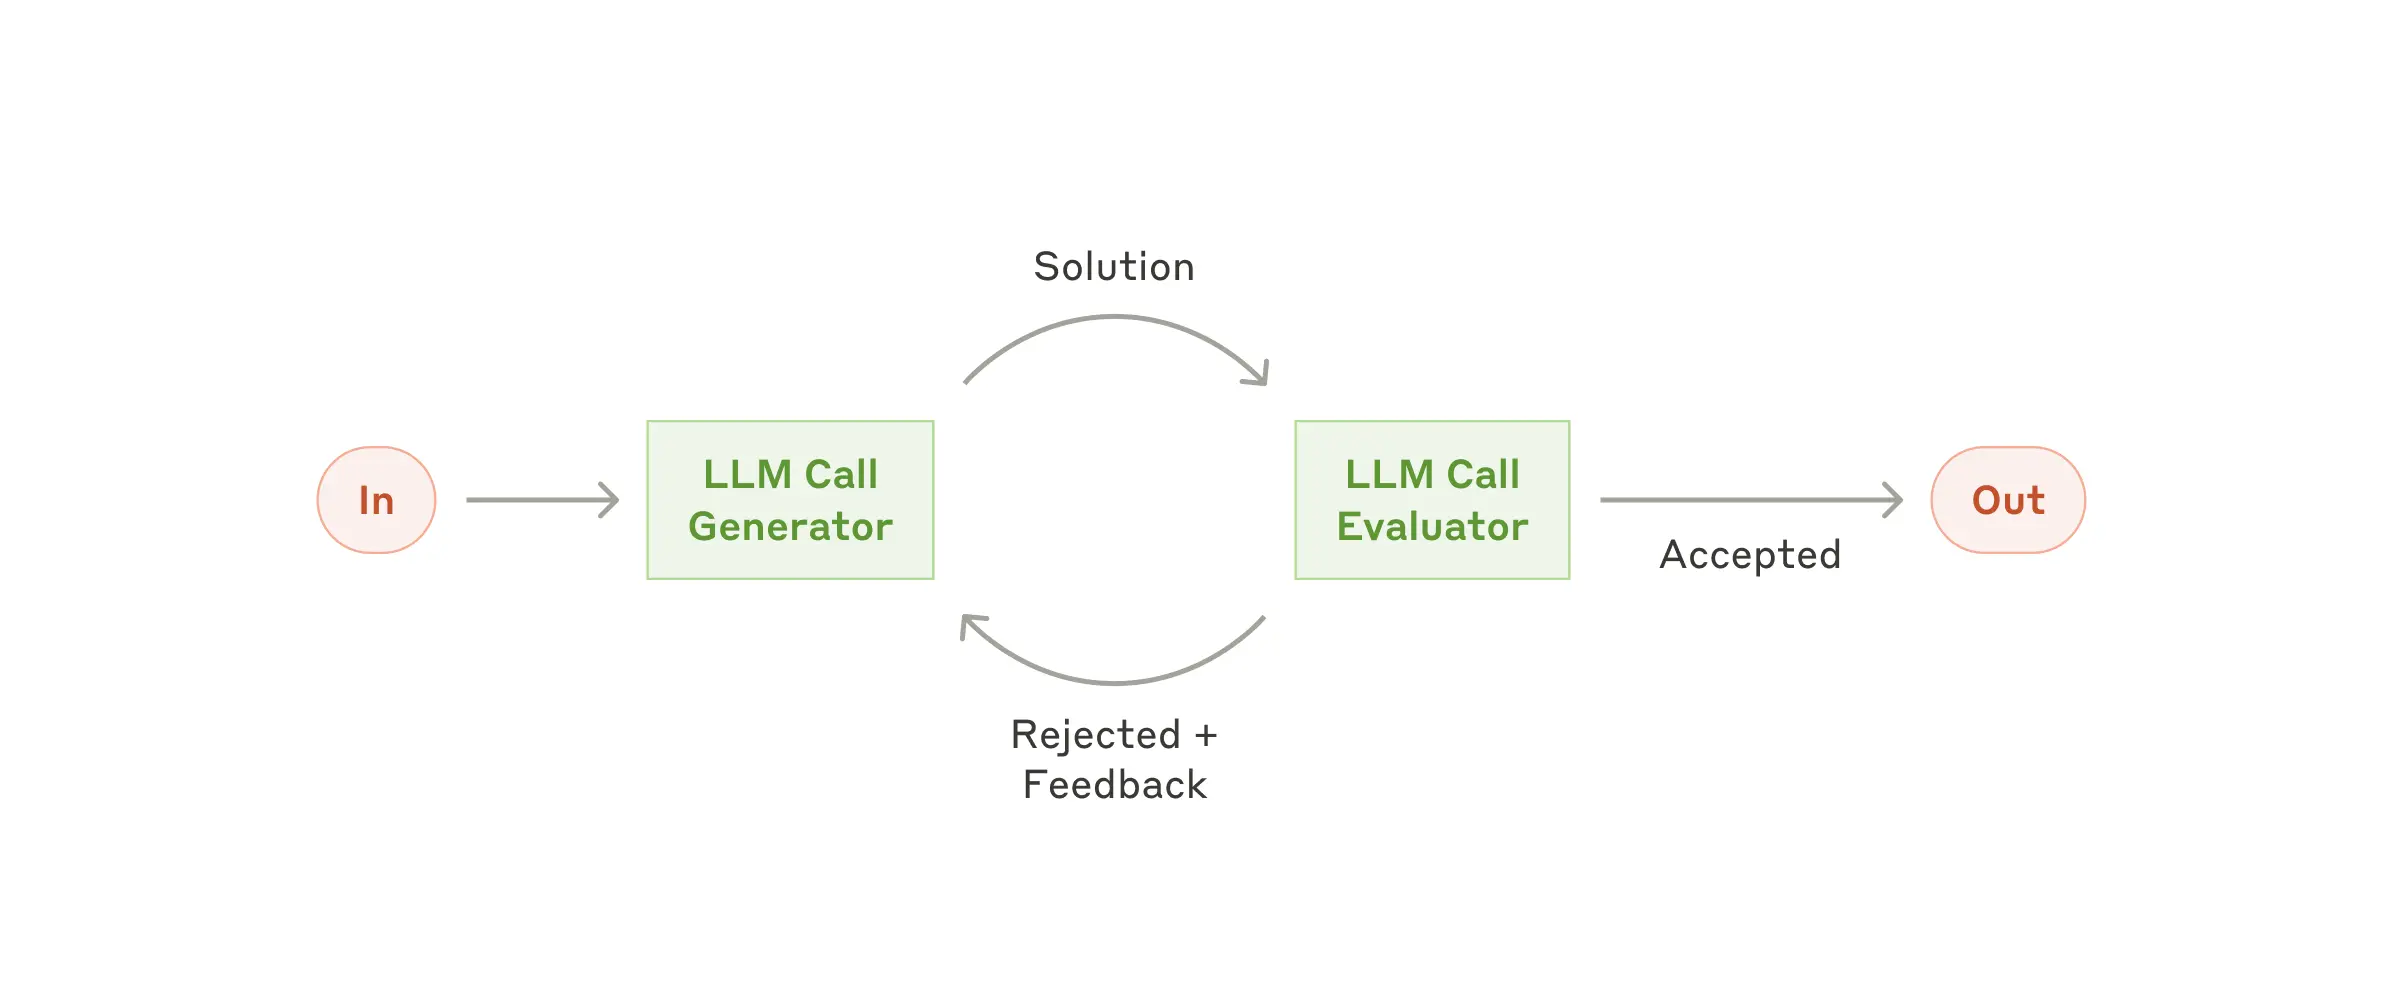
Evaluator-optimizer(评估者—优化者)让一个模型先生成结果,另一个模型或程序按评价标准检查,并将反馈交给生成者修改。这个过程重复进行,直到通过检查或达到停止条件。
输入
   ↓
Generator:生成初稿
   ↓
Evaluator:依据标准检查
   ├─ 通过 → 输出
   └─ 未通过 + 修改意见 → Generator 再生成
例如翻译任务可以检查术语、语气和遗漏,再让生成者按意见修改。它适合评价标准明确、反复修改能带来可衡量提升的任务。应设置最大迭代次数,并让反馈具体可执行;否则模型可能一直循环,或在模糊反馈下反复改写却没有实质改善。
五种模式怎么选?
- 步骤和顺序固定:考虑提示链。
- 输入类别不同,需要走不同流程:考虑路由。
- 子任务独立,或需要多次判断:考虑并行化。
- 子任务要根据输入临时确定:考虑编排者—工作者。
- 有清晰标准,值得迭代打磨:考虑评估者—优化者。
这些模式并不互斥。一个复杂系统可以先用路由识别任务,再由编排者安排工作者并行处理,最后用评估者检查结果。选择时先看任务步骤是否固定、子任务是否独立、是否需要动态拆解,以及结果能否用明确标准评估。
这些模式怎么实现:自己编排还是用框架?
两种方式都可以。框架不会替我们决定业务流程;它主要提供模型接入、状态管理、节点编排、并发执行、重试和持久化等基础设施。即使使用框架,我们仍要定义每一步做什么、步骤之间怎样传递数据,以及什么条件下继续或停止。
如果目标是学习原理,或流程只有几步,自己编排通常最清楚。以 Java 为例,可以把每一步写成方法:提示链按顺序调用方法;路由用分类结果选择分支;并行化用线程池或 CompletableFuture 发出独立任务,并等待结果后汇总;编排者—工作者先让模型生成结构化子任务,再由程序分派给工作者;评估者—优化者则用有上限的循环完成“生成—评价—修改”。
自己实现的好处是调用过程透明、容易调试,也能直接看见工作流和普通 Java 代码的关系。代价是系统变复杂后,需要自己补上超时、重试、并发限制、错误处理、运行记录和状态保存;如果这些细节没有设计好,流程中断后可能无法恢复,模型调用也可能无限重试。
如果项目已经使用 Spring,可以用 Spring AI 的 ChatClient 统一调用模型,并组合工具调用等能力。它帮我们处理一些模型交互环节,但具体工作流仍由应用程序编排。
对于更复杂的 Java Agent 工作流,可以进一步看 Spring AI Alibaba Graph 和它的 Agent Framework。Graph 把步骤组织成节点,让节点通过共享状态和条件边连接;框架也提供顺序、并行、路由和循环等常用结构,并支持更完整的流程编排能力。采用前要核对项目所需的 JDK、Spring 和依赖版本;当前仓库说明要求 JDK 17 或更高版本,而本章的基础 Demo 使用 Java 11。
一个实用的学习路径是:先用普通 Java 把五种模式分别写出来,确认自己理解了调用顺序和数据流;当开始需要持久化状态、失败恢复、人工审核、追踪每个节点等能力时,再引入框架。这样换了框架,也仍然知道它帮我们接管了哪部分工作。
小结
这五种模式关心的都是同一个问题:程序如何安排模型完成工作。提示链强调依次执行,路由强调分类分流,并行化强调同时处理,编排者—工作者强调动态拆解,而评估者—优化者强调反馈循环。理解这些模式后,我们就能根据任务特点设计合适的调用流程,而不是把所有工作都塞进一次模型请求。