从最小 Agent 看懂工具、检索与记忆
上一篇《什么是 AI Agents》里,我们把 Agentic System 的基础构件归纳为增强型 LLM:一个被检索、工具和记忆增强过的大语言模型。
这次,我们从一个最小 Agent 开始,逐个理解这些构件,并通过编码实现它们。本章涉及的示例代码都集中放在项目目录中:工具调用在 MinimalAgentLoop.java,检索在 MinimalRagDemo.java,记忆在 MinimalMemoryDemo.java。
代码仓库:https://gitee.com/toxplore/ai/tree/master/Page2
从一个最小 Agent 开始
我们先让模型解决一个简单问题:计算 123 × 456。
如果直接让模型回答,它可能会自己算,也可能算错。现在我们给它一个计算器工具,让它在需要时调用:
用户提问
  ↓
模型判断是否需要计算
  ↓
模型请求调用 calculator
  ↓
Java 程序执行计算
  ↓
程序把结果交回模型
  ↓
模型生成回答
这里有个容易混淆的地方:模型并没有真的运行计算器。它只是根据请求中提供的工具说明,返回“调用哪个工具、参数是什么”。真正执行计算的是我们的 Java 程序。
我的理解:模型负责决定要不要用工具,程序负责执行工具。两边来回配合,就构成了最小的工具调用循环。
工具:让模型能够采取行动
为什么我们可以把工具“交给”大模型?这不是因为模型能直接访问 Java 程序,而是模型服务商在 API 中提供了 Function Calling(函数调用)能力,约定了调用方和模型之间如何描述工具、传递调用请求和返回执行结果。
调用方把工具名称、用途和参数格式随请求一起发送。支持 Function Calling 的模型会结合用户问题和工具说明,选择直接回答,或者按约定的结构返回一个工具调用请求。这个请求只是“请程序调用某工具并传入这些参数”,还没有真正执行函数。
程序 ──工具说明 + 用户问题──→ 模型
程序 ←──结构化工具调用请求── 模型
程序执行工具,再把结果作为消息发回模型
所以,Function Calling 可以理解为模型服务提供的一种结构化 API 交互方式:模型负责选择工具并生成参数,应用程序负责校验、执行和回传结果。不同服务商提供的格式相近,但细节不一定完全相同。
把工具交给模型使用,可以拆成三步:在程序里注册工具;把工具说明发给模型并读取模型的调用请求;由程序执行工具,再把结果交回模型。
1. 设置并注册工具
这里注册一个名为 calculator 的计算器。工具说明和参数结构会发给模型;最后一行的执行函数留在 Java 程序本地。
private static final ToolSpec CALCULATOR = new ToolSpec(
    "calculator",
    "计算只包含数字、括号和 + - * / 的算式。",
    "{\"type\":\"object\",\"properties\":{\"expression\":{\"type\":\"string\"}},"
        + "\"required\":[\"expression\"],\"additionalProperties\":false}",
    arguments -> Calculator.calculate(
        String.valueOf(arguments.get("expression"))));
2. 把工具交给模型,读取它的调用请求
请求中包含对话消息、工具定义和 tool_choice: auto。这表示模型可以根据问题自行选择调用工具,也可以直接回答。
requestJson.set("messages", toApiMessages(messages));
requestJson.set("tools", toApiTools(tools));
requestJson.put("tool_choice", "auto");
如果模型决定调用计算器,会返回类似这样的数据:
{
  "tool_calls": [{
    "id": "call_123",
    "function": {
      "name": "calculator",
      "arguments": "{\"expression\":\"123 * 456\"}"
    }
  }]
}
Java 程序读取返回里的工具名和参数,转换成内部的 ToolCall 对象:
String callId = callNode.path("id").asText();
JsonNode function = callNode.path("function");
String name = function.path("name").asText();
JsonNode argumentsNode = function.path("arguments");
JsonNode parsedArguments = argumentsNode.isTextual()
        ? mapper.readTree(argumentsNode.asText())
        : argumentsNode;
Map<String, Object> arguments = mapper.convertValue(
    parsedArguments,
    new TypeReference<Map<String, Object>>() {});

calls.add(new ToolCall(callId, name, arguments));
3. 执行工具,把结果交回模型
程序根据工具名找到本地注册的执行函数,用模型给出的参数运行计算器。接着把结果作为一条 tool 消息加入对话,再请求模型继续回答。
private String runTool(ToolCall call) {
    ToolSpec tool = tools.get(call.name);
    if (tool == null) {
        return "工具错误:未注册的工具 " + call.name;
    }
    try {
        return String.valueOf(tool.executor.execute(call.arguments));
    } catch (Exception exception) {
        return "工具执行失败:" + exception.getClass().getSimpleName()
                + ": " + exception.getMessage();
    }
}
Agent 循环拿到执行结果后,再把它作为工具消息追加到会话;随后继续调用模型:
String result = runTool(call);
conversation.add(Message.toolResult(call.name, call.callId, result));
回传结果后,Agent 循环会再次请求模型。模型读到计算结果,才生成面向用户的最终回答。未注册的工具会被拒绝;工具执行失败时,程序会把简短错误信息交给模型处理。
我的理解:工具的“说明”给模型看,工具的“执行函数”由程序掌管,模型提出调用,程序执行并返回结果。
本次 Demo 使用的是阿里云百炼的 Function Calling 接口。其他模型服务也可能提供类似能力,但字段和行为不一定完全一致;更换模型或服务时,仍要查看对应文档。
检索:先找到资料,再让模型回答
如果我们问的是常识问题,通常可以直接问模型。但如果问题涉及一份指定文档,比如“《什么是 AI Agents》里怎么总结 Agent 的基础构件?”,模型不一定看得到这份文件。
这时可以先从文档里找到相关段落,再把它和问题一起发给模型:
读取文档 → 切分片段 → 检索相关片段
                       ↓
             片段 + 用户问题 → 模型回答
我们的 RAG Demo 就是这样工作的:启动时读取 HTML、切成文本片段;用户提问后,程序给片段打分,挑出匹配度最高的几段,再把它们拼进模型请求中。
代码先取出得分最高的三个片段,拼成上下文,再把上下文和原问题一起交给模型:
List<Hit> hits = retrieve(question, chunks, 3);
StringBuilder context = new StringBuilder();
for (int i = 0; i < hits.size(); i++) {
    Hit hit = hits.get(i);
    context.append("[片段 ").append(i + 1).append("] ")
           .append(hit.text).append("\n\n");
}

String answer = askModel(apiKey, baseUrl, model,
                         question, context.toString());
模型请求中的用户消息则把资料片段和问题放在一起:
messages.addObject()
    .put("role", "user")
    .put("content", "资料:\n" + context
            + "\n用户问题:" + question);
当前 Demo 用的是字符二元组重叠:把问题拆成相邻的两个字符,统计每个片段命中了多少组,再按命中比例排序。它只是一个帮助理解流程的简单算法,不是语义检索。比如“基础构件”和“基本组成”意思相近,但字面字符差异较大,简单匹配可能找不到。
实际项目可以把文档提前处理并建立索引,收到问题后只取相关的少量内容。检索的价值在于让模型回答时能够参考指定资料,而不是只依赖模型原本掌握的知识。
记忆:让模型能够接续对话
模型不会自动记住上一次 API 调用的内容。如果希望它接续之前的聊天,程序需要把对话历史再次放进请求中。
最简单的做法是保留消息列表。每次请求时,程序把这些历史消息和新问题一起发给模型,模型于是能根据上下文回答。
Demo 中,每次请求先把较早对话摘要放进 system 消息,再把近期历史逐条加入请求:
String system = "你是一个有短期对话记忆的助手。请结合本轮提供的记忆摘要和近期对话回答。"
        + (memory.summary.isEmpty() ? ""
        : "\n较早对话摘要:\n" + memory.summary);
messages.addObject().put("role", "system").put("content", system);

for (ChatMessage message : memory.messages) {
    messages.addObject()
        .put("role", message.role)
        .put("content", message.content);
}
但对话变长后,每次都提交全部历史会增加 token 消耗,也可能超过模型的上下文长度。我们的记忆 Demo 用了一个简单办法:保留最近几轮对话;较早的内容超过上限后,让模型压缩成摘要。
较早对话 → 摘要
近期对话 → 保留原文

摘要 + 近期对话 → 下一次模型请求
达到上限后,程序把较早对话交给模型生成新摘要,再用新摘要替换旧摘要并移除对应的旧消息:
if (memory.shouldCompress()) {
    String summary = summarize(apiKey, baseUrl, model, memory);
    memory.applySummary(summary);
}
上面的代码是压缩入口。Demo 在近期消息数超过上限时触发压缩,通常按完整的问答对处理,不把一轮对话拆开:
boolean shouldCompress() {
    return messages.size() > KEEP_RECENT_MESSAGES + 1;
}

int count = messages.size() - KEEP_RECENT_MESSAGES;
count = Math.max(2, count - (count % 2));
接着,summarize() 把要压缩的旧消息整理成对话文本,同时把已有摘要和旧对话一起发给模型。模型会在旧摘要基础上补充信息,而不是每次从零开始总结:
StringBuilder oldTranscript = new StringBuilder();
for (int i = 0; i < count; i++) {
    ChatMessage message = memory.messages.get(i);
    oldTranscript.append(message.role.equals("user") ? "用户:" : "助手:")
            .append(message.content).append('\n');
}

messages.addObject().put("role", "user").put("content",
        "已有摘要:\n" + memory.summary
                + "\n\n较早的对话:\n" + oldTranscript);
String newSummary = postChat(apiKey, baseUrl, body);
拿到新摘要后,程序保存它,并从消息列表中删除已经压缩的旧消息;最近几轮仍以原文保留:
summary = newSummary;
messages.subList(0, count).clear();
压缩后的摘要不是把对话逐字缩短,而是尽量保留后续还可能用到的信息,例如用户偏好、已确认的决定、当前任务和未完成事项。当前 Demo 将摘要和近期消息保存在 Java 进程的内存中,程序退出后就会清空;如果需要跨重启保留记忆,再将它们写入文件或数据库。
检索和记忆有什么区别?
两者都可能把信息放进模型上下文,但信息来源和用途不同:
| 能力 |
主要用途 |
例子 |
| 检索 |
从资料中找依据 |
查找 HTML 里的相关段落 |
| 记忆 |
延续之前的对话 |
记住已确认的决定 |
检索通常面对预先准备好的资料;记忆保存的是交互过程中值得后续使用的信息。工具则是执行计算、查询或其他动作。
把这些构件放回 Agent
工具、检索和记忆可以组合在一个 Agent 里,但不是每个问题都需要用到全部能力:
用户输入
   ↓
读取相关记忆
   ↓
需要参考资料时进行检索
   ↓
模型决定:直接回答,还是调用工具
   ↓
程序执行工具并回传结果
   ↓
模型生成回答
   ↓
更新记忆
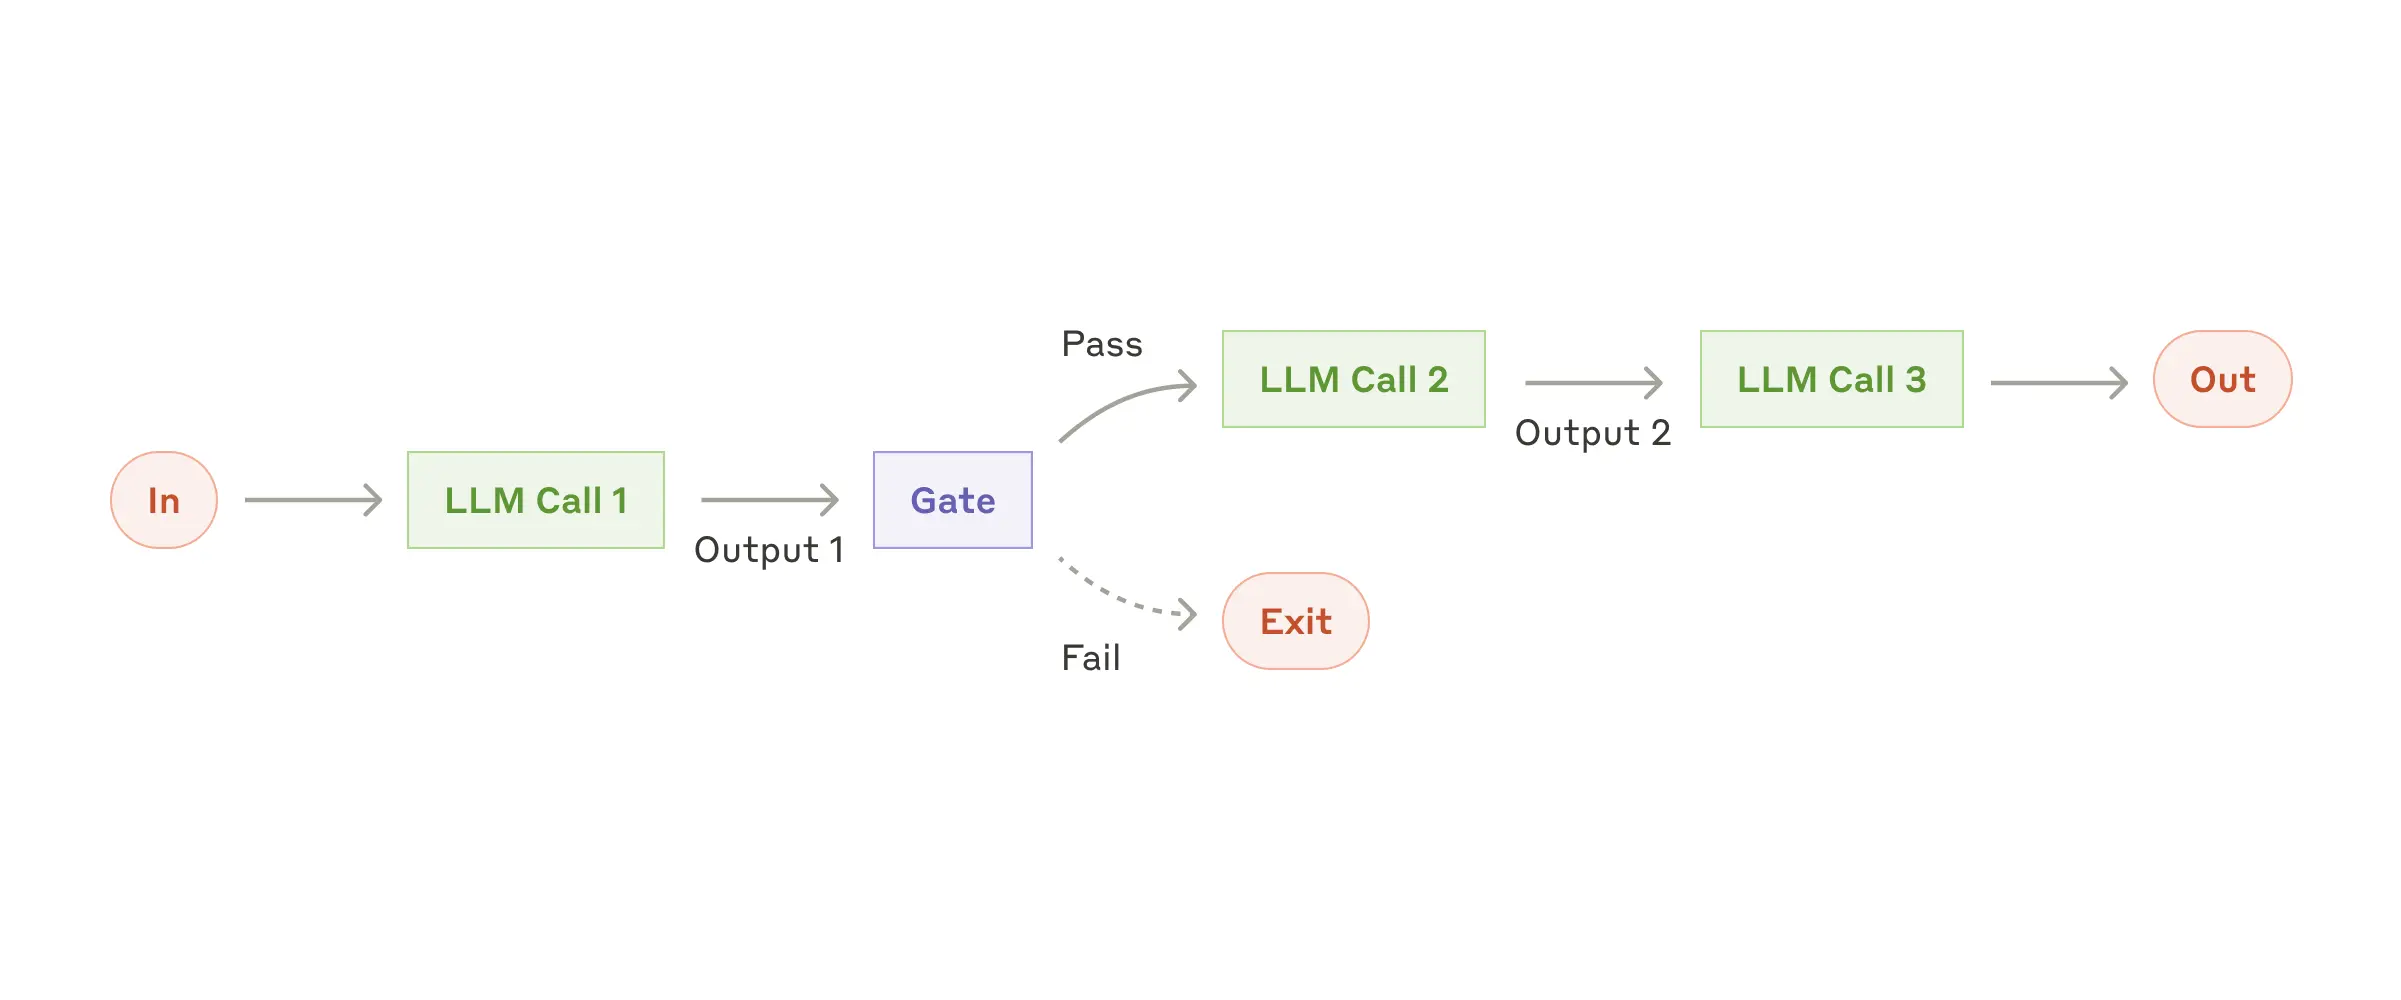
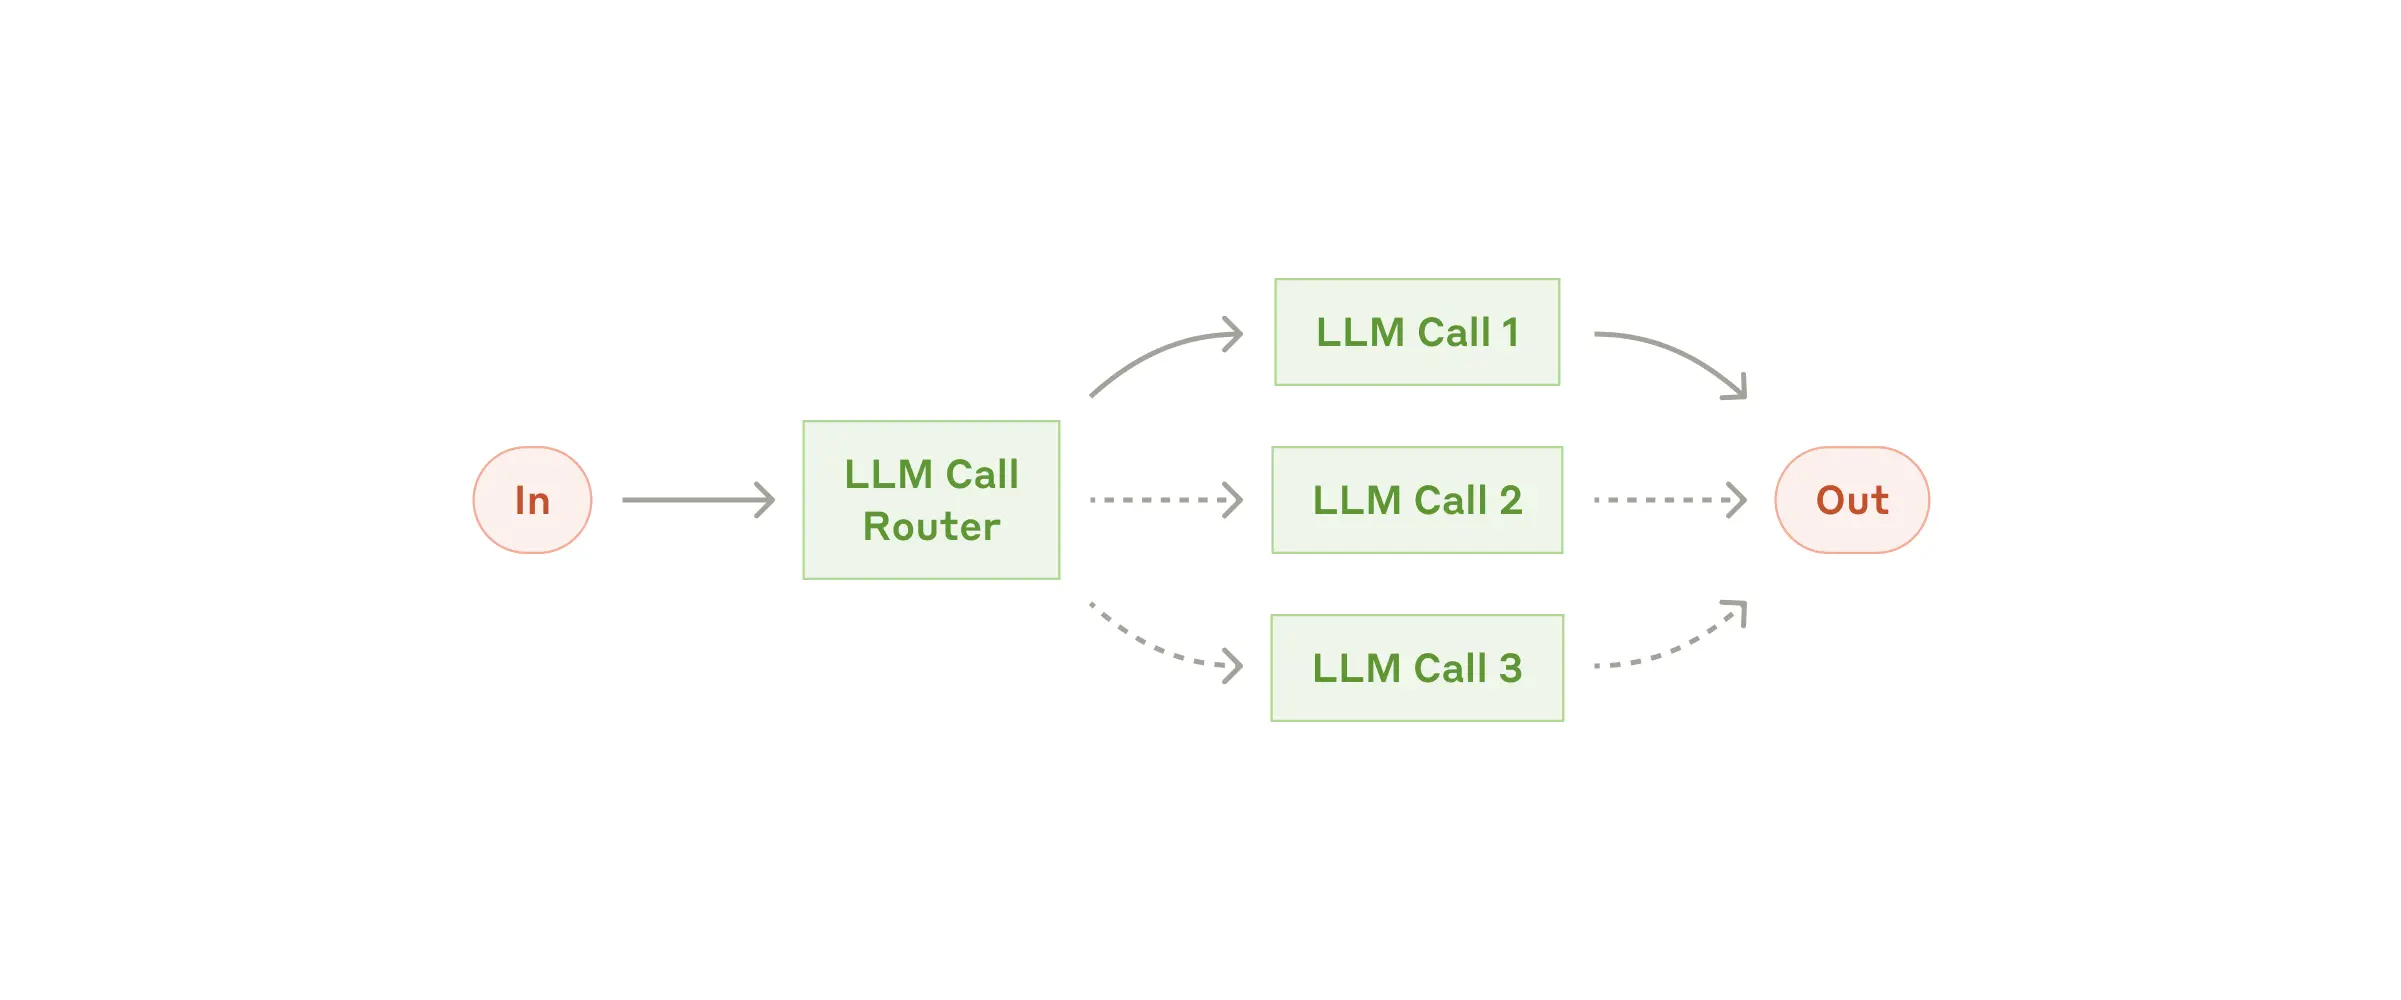
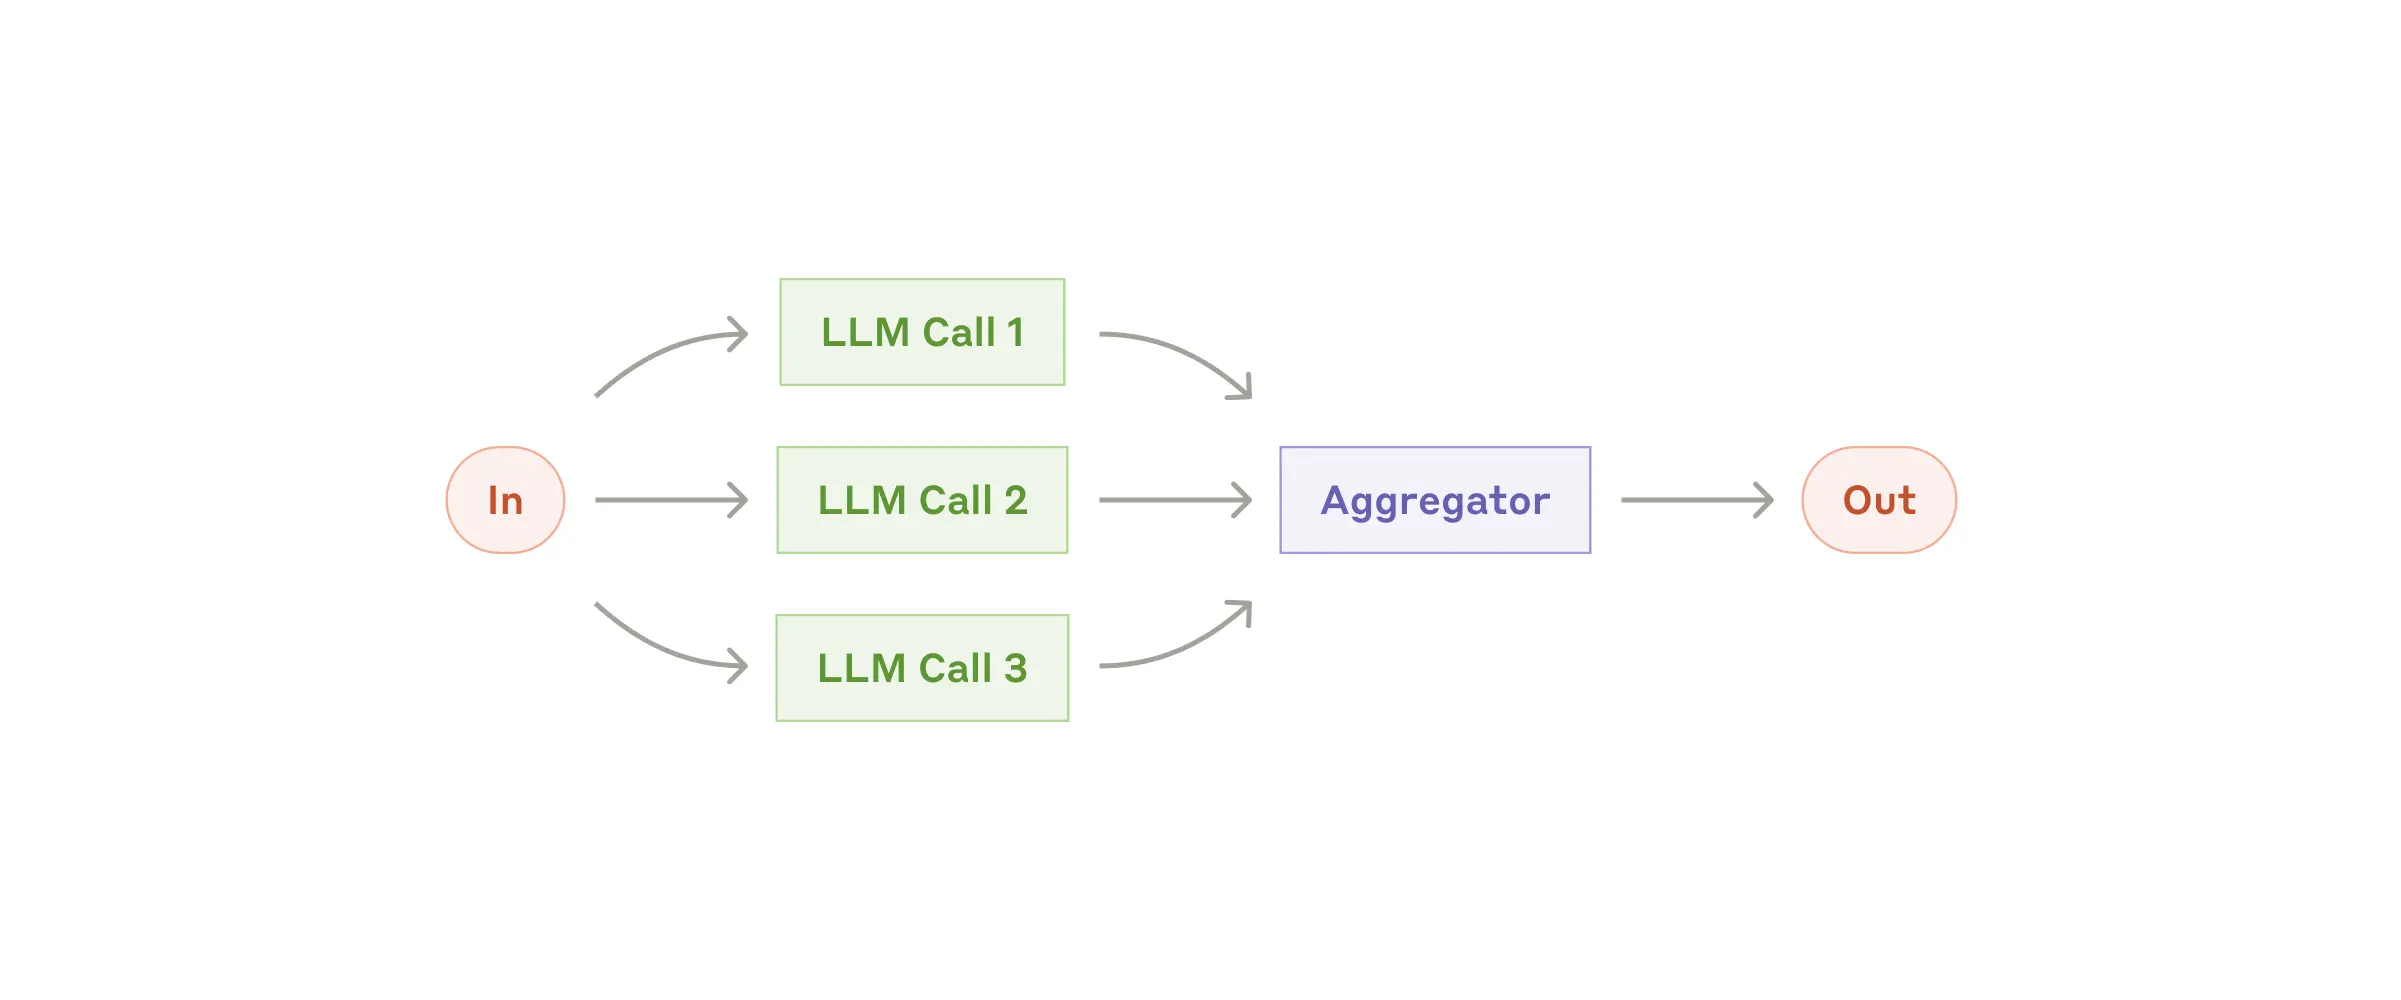
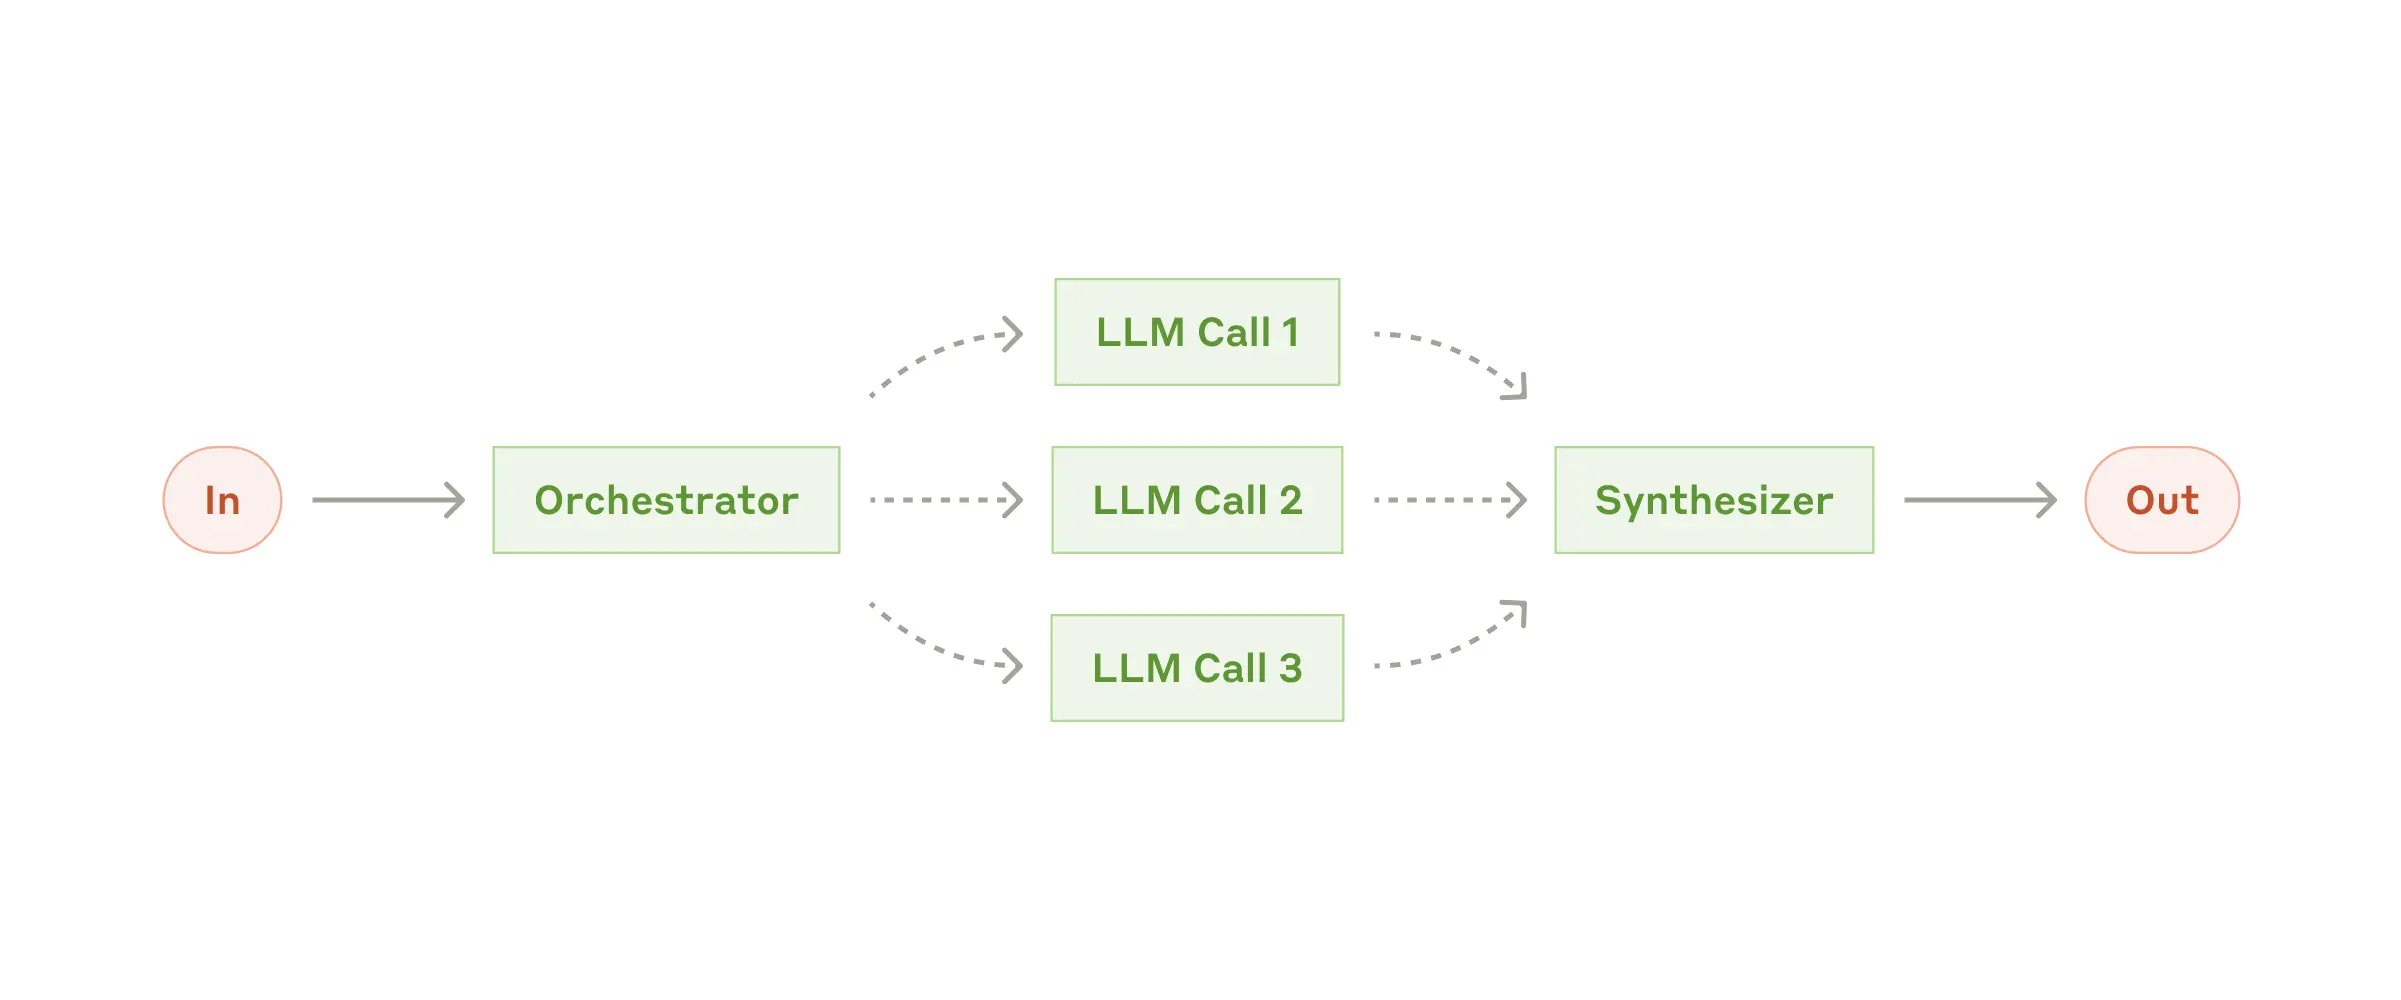
如果下一步由模型根据问题和工具结果动态决定,流程就更接近 Agent;如果下一步始终由代码预先规定,则更接近 Workflow。
小结
- 工具让模型可以请求程序执行操作。
- 检索从外部资料中找出相关内容,交给模型参考。
- 记忆让程序在后续请求中重新提供有用的对话信息。
- 历史压缩能减少每次请求携带的对话内容,但摘要可能遗漏信息,需要根据实际用途设计。
这些 Demo 都刻意保持简单:计算器只处理基本运算,检索使用字面匹配,记忆只存在进程内。它们的目标是先看清楚数据如何流动,再逐步替换成更实用的实现。
下一步
接下来可以把计算器、文档检索和对话记忆组合进同一个 Agent,并打印每一步的输入、检索结果、工具调用和记忆变化。这样就能从三个独立 Demo 走向一个完整的小型 Agent。